Yazar: @atilayberber
Terminalde nasıl çalıştığımızı düşünün: Programlar çalıştırıyoruz, programlar dosya okuyup yazıyor, hem programlar hem veri dosya sisteminde yaşıyor.
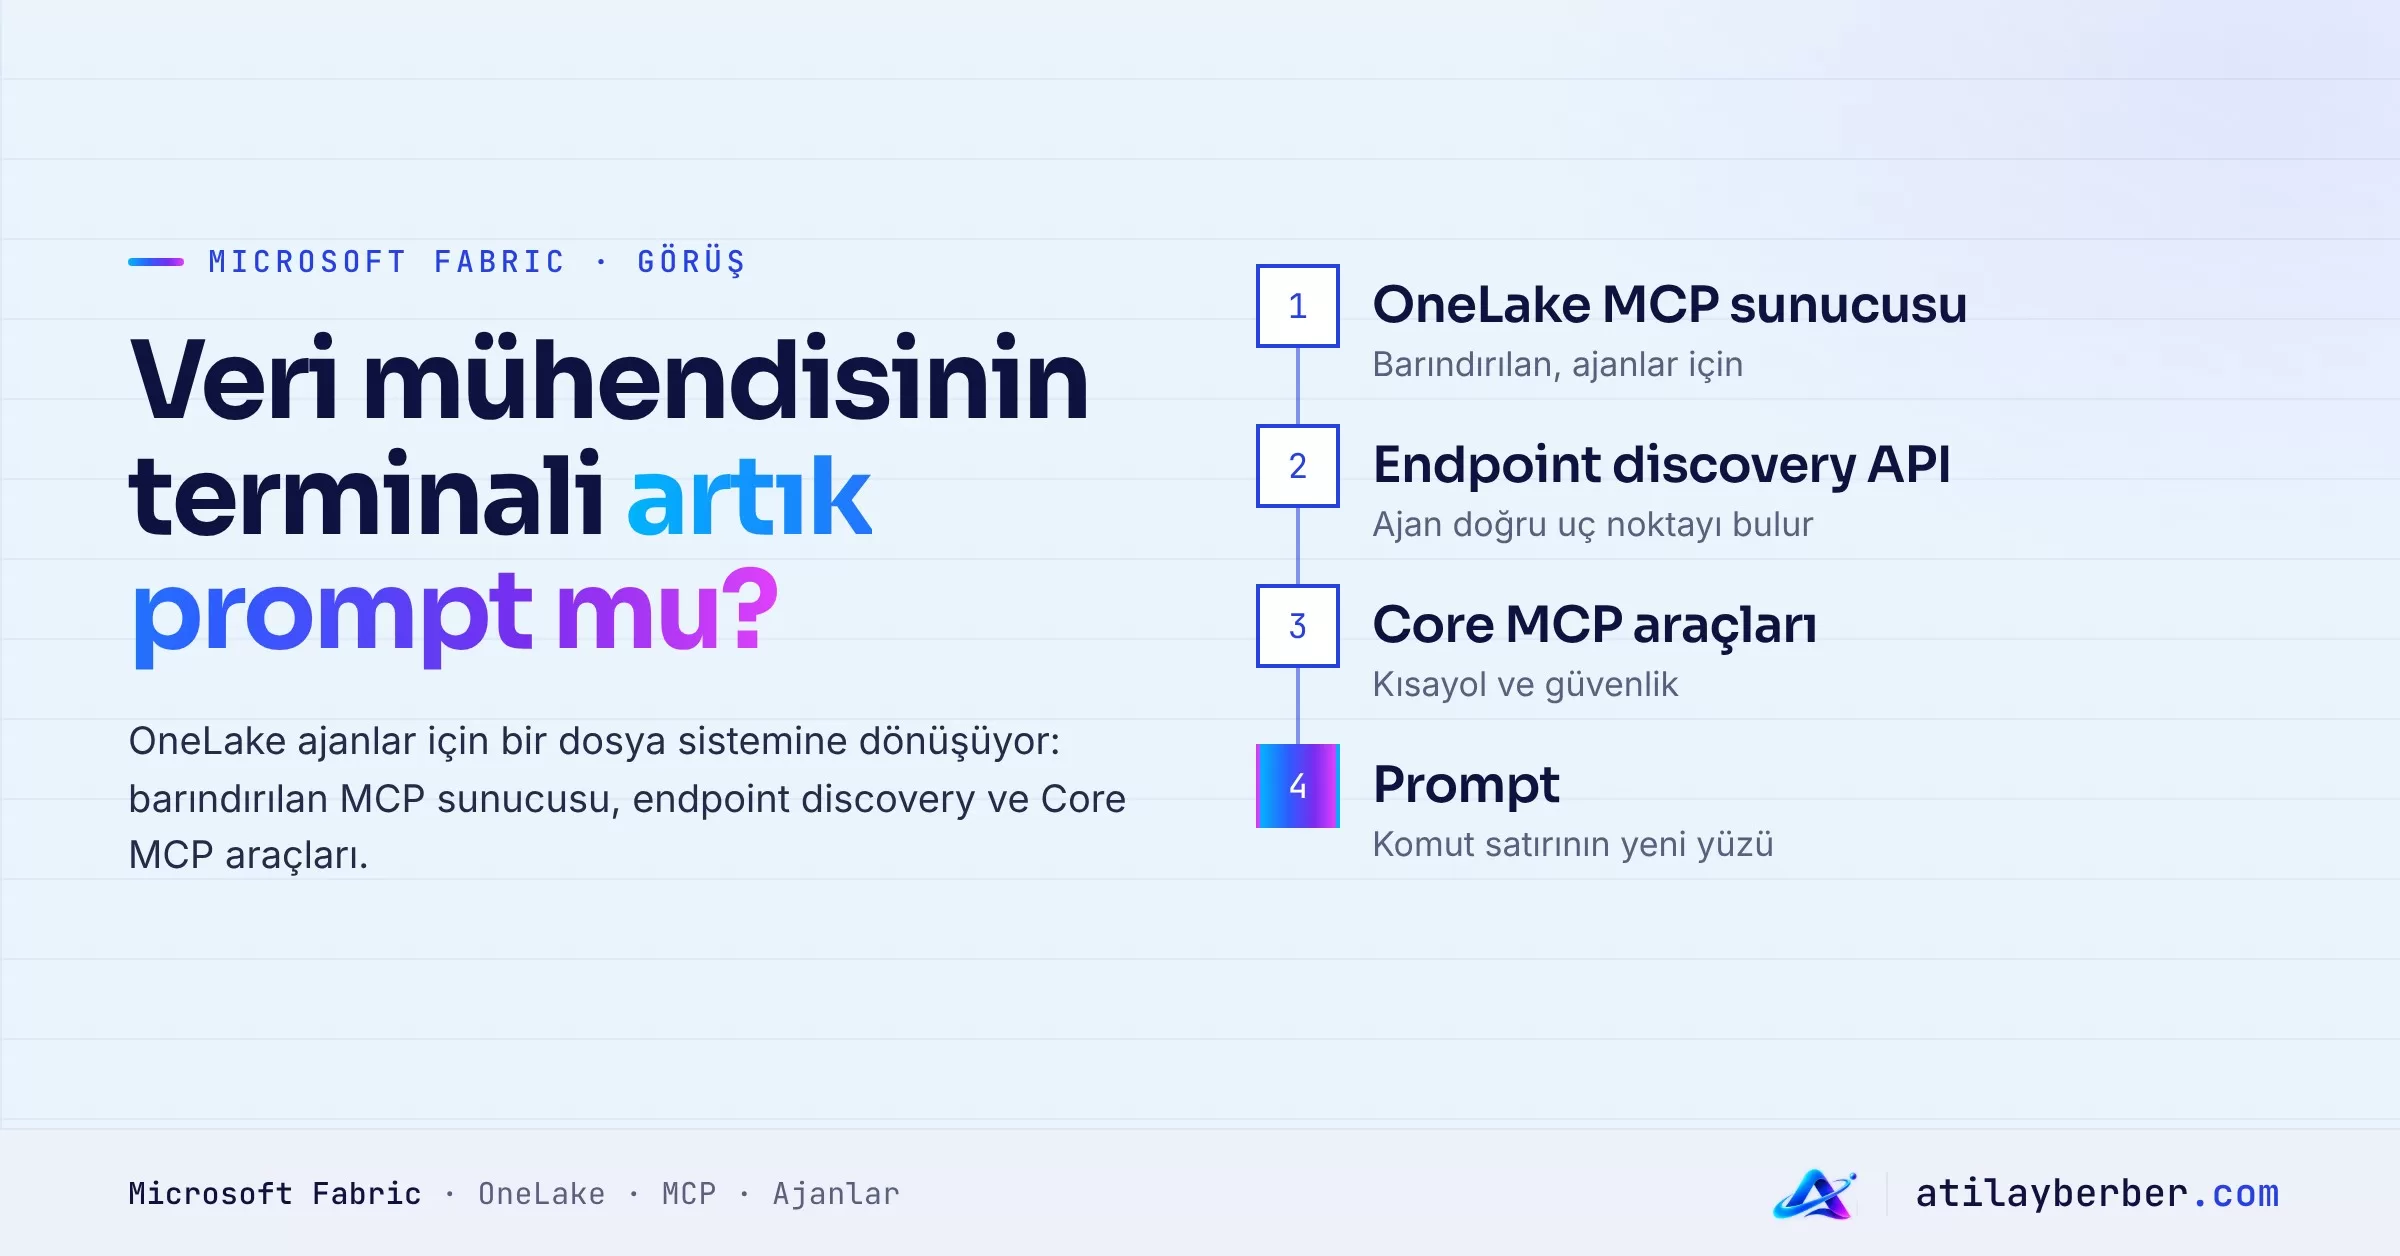
Microsoft’un OneLake ekibi bu benzetmeyi veri mühendisliğine uyguluyor: OneLake dosya sistemi, Fabric motorları programlar, yapay zekâ prompt’u da terminal. Son birkaç haftada yayımlanan özellikler tam olarak bu fikre hizmet ediyor.
Ajan tabanlı veri mühendisliğinin büyük resmini ve Osmos’u bu yazıda tartışmıştım. Bu yazı daha somut: Bir ajan bugün OneLake’te ne yapabiliyor ve bunu hangi araçlarla yapıyor?
Kısaca
- Barındırılan OneLake MCP sunucusu (önizleme): Ajanlar yerel sunucu kurmadan OneLake’teki veriyi keşfedip yönetebiliyor. Yerel seçenek de duruyor.
- Fabric Core MCP sunucusuna yeni araçlar: Kısayol (shortcut) ve OneLake security yönetimi.
- Endpoint discovery API (önizleme): Bir öğe için hangi Fabric motorlarının kullanılabildiğini ve onlara nasıl bağlanılacağını (skill, MCP sunucusu ya da motor uç noktası) döndürüyor.
- Sonuç: Bir ajan doğru veriyi bulup doğru motora bağlanarak tek bir prompt’tan cevap üretebiliyor.
- Hepsi mevcut yetkilerinizle çalışıyor; ajan sizin göremediğinizi göremiyor.
Üç parça, tek akış
1. OneLake’i yönetmek: barındırılan MCP sunucusu
MCP (Model Context Protocol), yapay zekâ ajanlarının araçlara standart bir yolla bağlanmasını sağlıyor. OneLake artık bulutta barındırılan bir MCP sunucusu sunuyor; GitHub Copilot ya da başka bir MCP uyumlu istemci, kurulum yapmadan bağlanabiliyor.
Microsoft’un örneğinde ajana tek bir cümle veriliyor: “UK Property Data çalışma alanımdaki House Price Open Mirror’da ne olduğunu belgele.” Ajan çalışma alanını buluyor, tablo şemasını keşfediyor, alttaki dosyaları eşliyor ve çoğaltmanın sağlığını kontrol ediyor.
Core MCP sunucusuna eklenen OneLake security araçlarıyla belgelemeye güvenlik de giriyor: Bir tabloya uygulanan güvenlik rollerini ve yetkileri ajan listeleyebiliyor.
Fabric Core MCP sunucusunun genel kullanıma geçişini Fabric Eylül 2026 güncellemesi yazımda anlatmıştım. Yeni olan, OneLake’in kendi barındırılan sunucusu ve kısayol/güvenlik araçları.
2. Nasıl sorgulanacağını bilmek: endpoint discovery API
Ajanın veriye erişmesi yetmiyor; onu en iyi nasıl sorgulayacağını da bilmesi gerekiyor. Bir mirrored database’e T-SQL ile mi, Spark ile mi, yoksa doğrudan Delta dosyalarına mı gitmeli?
Endpoint discovery API bu soruyu cevaplıyor. Bir öğe için şunları döndürüyor:
- O öğede kullanılabilen Fabric motorları ve hangisinin önerildiği (örneğin mirrored database için SQL Analytics).
- Her motor için MCP sunucusu adresi, skill önerisi (örneğin
sqldw-cli) ve bağlantı uç noktaları. - OneLake’in kendisi için DFS, Blob, ABFS, Delta (Unity Catalog uyumlu) ve Iceberg REST uç noktaları.
Yani ajan, “bu öğe türü hangi motoru destekler” bilgisini kodda tutmak zorunda değil; sorup öğreniyor. Microsoft’un örneğinde GitHub Copilot, “Hampshire’da 2020’de kaç ev satıldı?” sorusunu discovery API’nin döndürdüğü skill ile doğru T-SQL sorgusuna çeviriyor.
3. Veriyi birleştirmek: kısayollar ve shortcut transform
Sorgulamak için verinin OneLake’te olması gerekmiyor. Kısayollar kopya almadan dış veriye ulaşıyor; shortcut transform ise CSV gibi dosyaları kod yazmadan tabloya dönüştürüyor ve dosyalar değiştikçe tabloyu güncel tutuyor.
Microsoft’un uçtan uca örneği şöyle ilerliyor:
- Ajan, kullanıcının mevcut SharePoint bağlantısıyla OneDrive’daki bir CSV klasörüne kısayol açıyor ve shortcut transform ile tabloya çeviriyor.
- Mirrored database’teki bir tabloya ikinci bir kısayol açıyor (mirrored database salt okunur olduğu için yeni bir lakehouse oluşturuluyor).
- İki kaynağı birleştiren soruyu cevaplıyor.
- Lakehouse’un Spark uç noktasını kullanarak bir korelasyon analizi çalıştırıyor; bunun için discovery API’nin döndürdüğü Spark CLI skill’ini seçiyor.
Blog yazısı bu akışı şu cümleyle bitiriyor: Geriye sonuçları kontrol etmek kalıyor. Bence yazının en önemli cümlesi bu.
Ne değişiyor?
Bu araçların hiçbiri tek başına devrim değil. Ama birlikte bir şeyi değiştiriyor: Veri platformu artık iki tür kullanıcı için tasarlanıyor, insanlar ve ajanlar.
- Keşif maliyeti düşüyor. “Bu veri nerede, şeması ne, hangi motorla sorgulanır?” sorusu bir prompt uzaklığında.
- Platform bilgisi koddan çıkıyor. Discovery API sayesinde ajanlar Fabric’in öğe türlerini ezberlemek zorunda değil.
- Açık formatlar öne çıkıyor. Iceberg REST ve Delta uç noktaları, ajanın DuckDB gibi Fabric dışı araçlarla da veriye gidebileceği anlamına geliyor.
Dikkat edilecekler
- Yetkiler artık her zamankinden önemli. Ajan sizin yetkilerinizle çalışıyor. Geniş yetkili bir hesapla çalışan bir ajan, geniş yetkili bir otomasyon demek. Kendi kullanıcınızın neye erişebildiğini gözden geçirin.
- Yazma işlemleri gerçek. Örnekteki ajan lakehouse oluşturuyor, kısayol açıyor, tablo üretiyor. Bunlar kapasite tüketir ve çalışma alanını kalabalıklaştırır. Ajanla denemeleri ayrı bir çalışma alanında yapın.
- Sonuç doğrulaması sizde. Örnekteki korelasyon analizi doğru çalışmış olabilir ama sorunun doğru kurulup kurulmadığını ajan bilemez. İstatistiksel bir sonucu karar verecek birine iletmeden önce kontrol edin.
- Önizleme. Barındırılan OneLake MCP sunucusu ve discovery API önizlemede; davranış değişebilir.
Benim notum: terminal prompt’a mı dönüşüyor?
Kısmen evet. Keşif, belgeleme ve tek seferlik analiz gibi işlerde prompt gerçekten yeni terminal olmaya aday. “Bu mirror’ı belgele” ya da “bu tablonun güvenlik kurallarını listele” gibi görevler bugün saatler sürüyor; ajanla dakikalara iniyor.
Ama üretim pipeline’ları için durum farklı. Orada tekrarlanabilirlik, sürüm kontrolü ve test önemli. Ajanın bir kez başarıyla yaptığı işi koda, pipeline’a ya da materialized view’a dönüştürmek hâlâ veri mühendisinin işi. Benim beklentim şu: Ajanlar keşif ve prototip katmanını devralacak, mühendisler ise o prototipi güvenilir bir sisteme çeviren kişiler olacak.
SQLBI’ın DAX için söylediği kural burada da geçerli: Araç zaman kazandırıyorsa kullanın, ama doğru davranışın tanımını insan kontrolünde tutun.
Nereden başlamalı?
- Ayrı bir test çalışma alanı açın; ajan denemeleri orada olsun.
- GitHub Copilot ya da kullandığınız MCP istemcisini barındırılan OneLake MCP sunucusuna bağlayın.
- İlk görev olarak yalnızca okuma isteyen bir şey verin: Bir lakehouse’u ya da mirror’ı belgeletin.
- Sonra discovery API ile bir öğenin hangi motorları desteklediğine bakın.
- Yazma işlemi isteyen görevleri (kısayol, lakehouse oluşturma) ancak bundan sonra deneyin.
Siz veri keşfi için bir ajanı ne kadar yetkiyle çalıştırırdınız: salt okunur mu, yoksa çalışma alanı katkıcısı olarak mı? LinkedIn’de yazın.