Yazar: @atilayberber
Bir yöneticiye “Bu ay 1.248.903 farklı müşteri alışveriş yaptı” dediğinizi düşünün. Sonra aynı rapordan “Yaklaşık 1,25 milyon” dediğinizi. Çoğu yönetici ikinci cümleyle karar verebilir. Ama bir kısmı rakamın sonundaki “yaklaşık” kelimesini görünce raporun tamamına güvenmeyi bırakır.
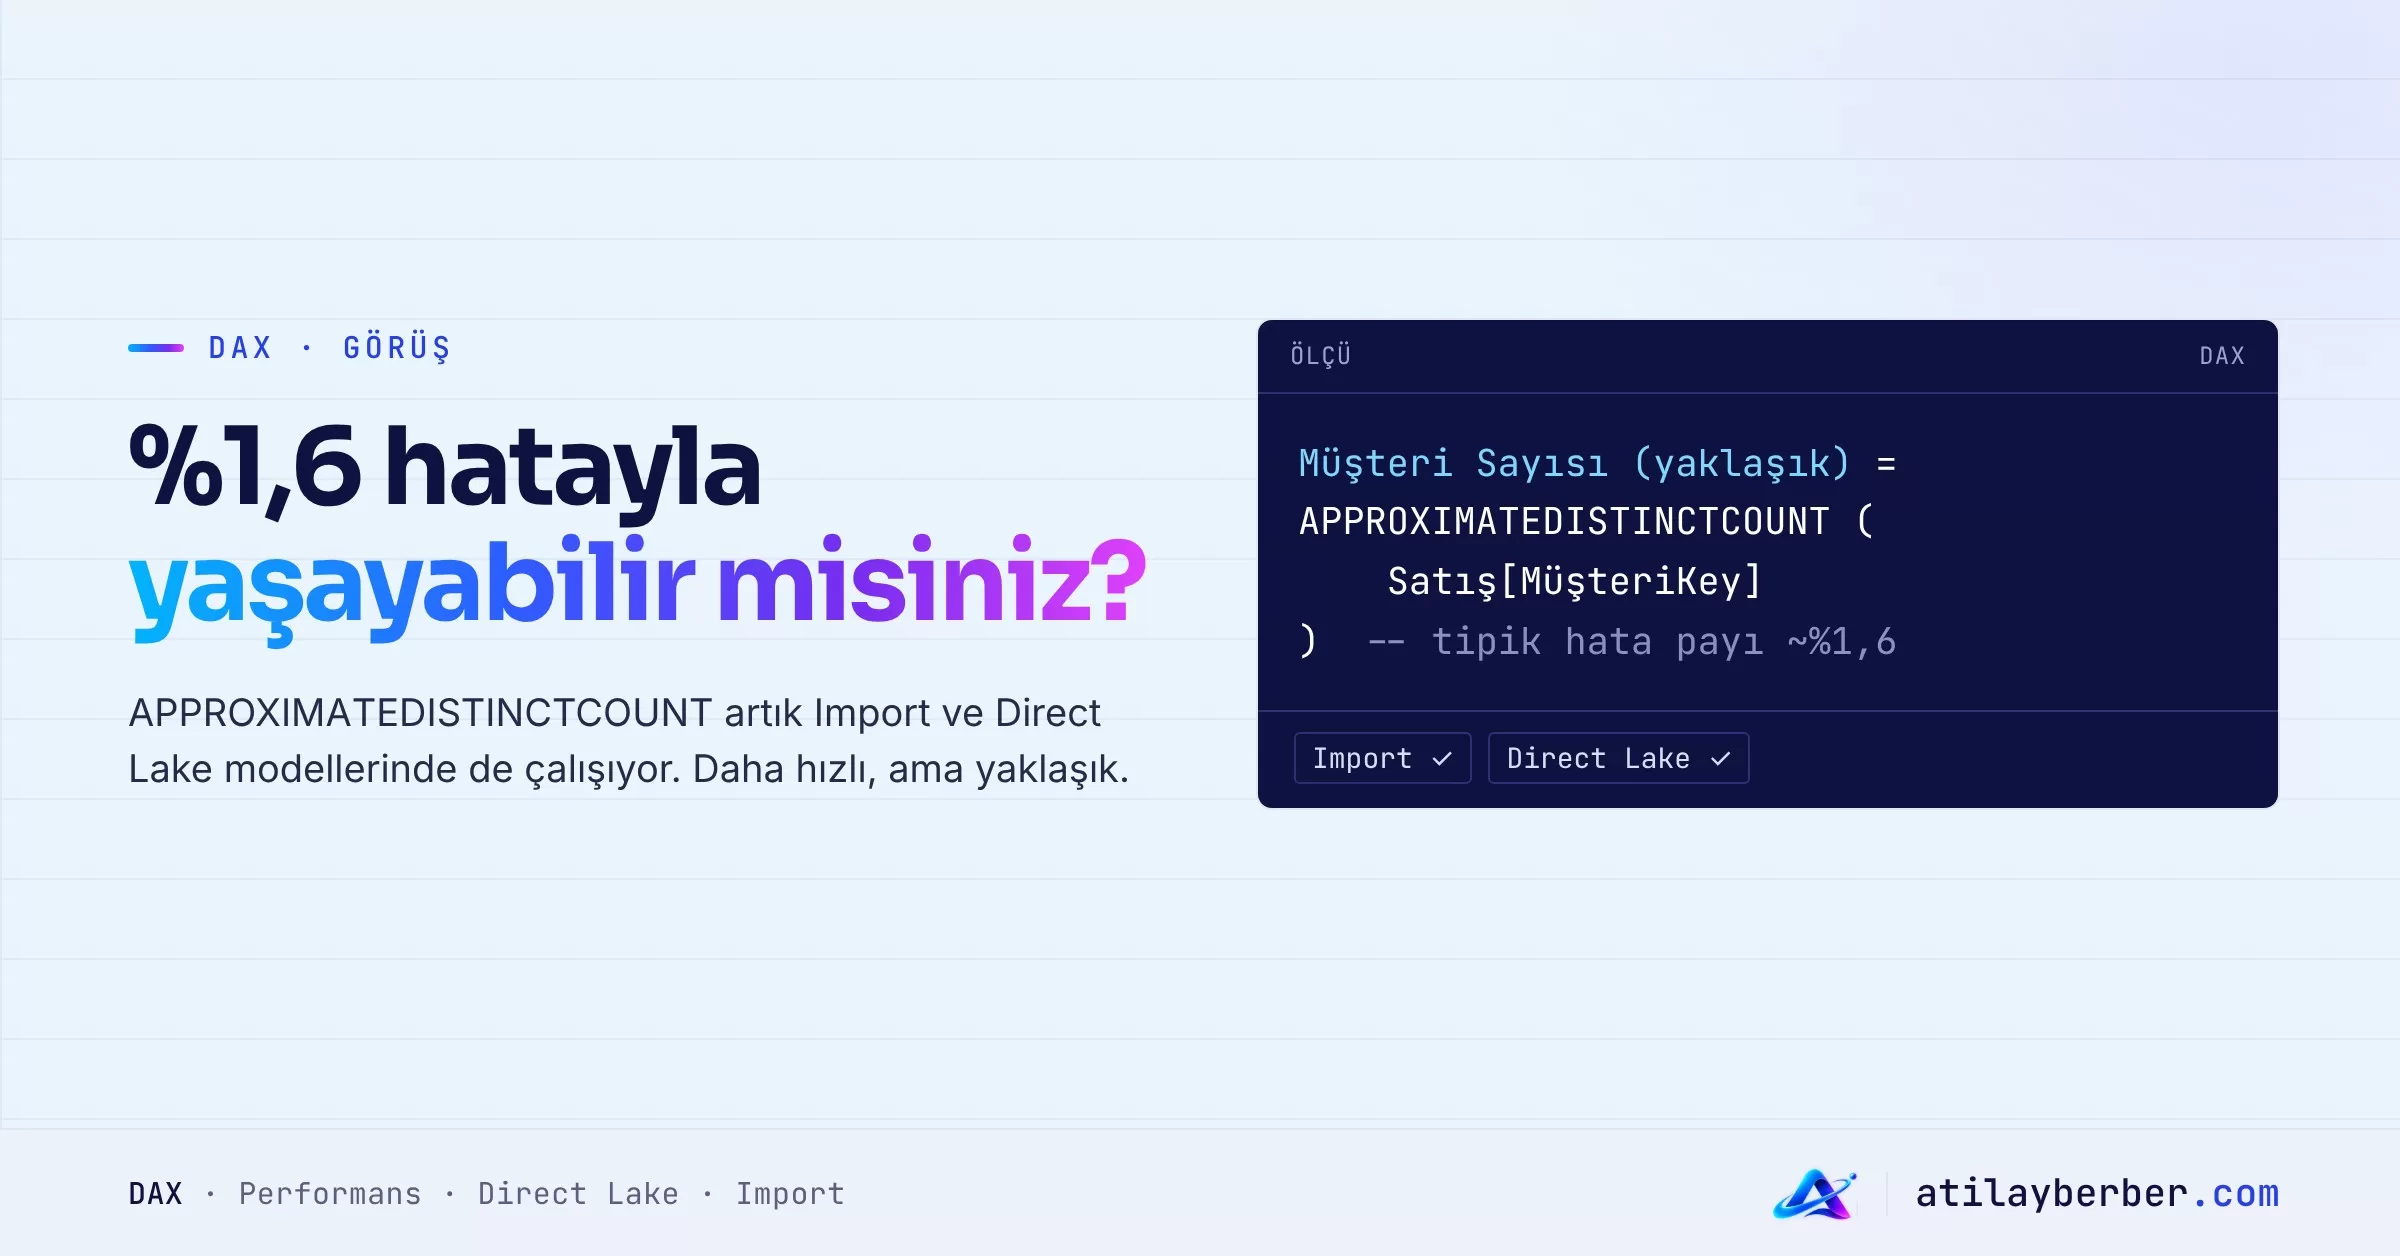
Power BI’ın Eylül 2026 güncellemesi bu tartışmayı tam ortaya koyuyor. APPROXIMATEDISTINCTCOUNT fonksiyonu artık Import ve Direct Lake modellerde de çalışıyor (önizleme). Daha hızlı ve daha az CPU kullanıyor, ama sonucu yaklaşık %1,6 standart hatayla tahmin ediyor.
Soru basit: BI raporlarında “yaklaşık doğru” kabul edilebilir mi?
Kısaca
APPROXIMATEDISTINCTCOUNTeskiden sadece DirectQuery kaynaklarında (Azure SQL, Synapse, BigQuery, Databricks, Snowflake) vardı. Artık Import, Direct Lake on OneLake ve Direct Lake on SQL’de de var.- İçeride HyperLogLog algoritması çalışıyor; standart hata yaklaşık %1,6.
- Chris Webb’in 1,4 milyar satırlık testinde sorgu yaklaşık 6 saniyeden 4 saniyeye indi, CPU süresi de belirgin biçimde azaldı. Buna karşılık bellek kullanımı arttı.
- Düşük kardinaliteli sütunlarda
DISTINCTCOUNT‘tan yavaş bile olabilir. - Benim görüşüm: Keşif ve trend için evet; finans, hedef ve resmî raporlama için hayır. En iyi çözüm, seçimi kullanıcıya bırakmak.
Ne değişti?
Fonksiyonun söz dizimi tek satır:
Yaklaşık Müşteri = APPROXIMATEDISTINCTCOUNT ( Satış[MüşteriID] )Asıl değişiklik nerede çalıştığında:
| Depolama modu | Davranış |
|---|---|
| Import | Motor içinde HyperLogLog (önizleme) |
| Direct Lake on OneLake | Motor içinde HyperLogLog (önizleme) |
| Direct Lake on SQL (fallback yok) | Motor içinde HyperLogLog (önizleme) |
| DirectQuery | Kaynağın kendi yaklaşık sayım fonksiyonuna iletilir |
Microsoft’un önerisi net: Yüksek kardinaliteli sütunlarda (işlem numarası, kullanıcı kimliği, zaman damgası) kullanın; ülke ya da durum gibi az değerli sütunlarda ve kesinlik gereken finansal metriklerde DISTINCTCOUNT‘ta kalın.
Hız gerçekten ne kadar artıyor?
Chris Webb, NYC Taxi örnek verisinden üretilmiş 1,4 milyar satırlık bir Direct Lake modelinde iki fonksiyonu karşılaştırdı. Tarih bazında distinct count sorgusunun sonuçları:
| Ölçü | Süre | CPU süresi | Bellek |
|---|---|---|---|
| DISTINCTCOUNT | ~6 sn | ~82 sn | ~206 MB |
| APPROXIMATEDISTINCTCOUNT | ~4 sn | ~48 sn | ~1,06 GB |
Kazanç gerçek ama mucize değil: süre üçte bir kısaldı, CPU yaklaşık yüzde 40 azaldı. Bedeli ise bellekte. Microsoft’un belgeleri de yaklaşık sayımın özellikle büyük modellerde, yoğun eşzamanlı kullanımda ve çok sayıda gruplamada daha fazla bellek kullanabileceğini söylüyor. Kapasiteniz zaten bellek sınırındaysa bu kazanç bir yerden geri ödenir. Fabric’te kapasite maliyetini konuştuğum yazıyla birlikte düşünmeye değer.
Bir not daha: Chris Webb’in yazısına gelen yorumlarda, Ekim 2026 Desktop sürümünde Import modelde ölçü oluştururken “bu depolama modunda desteklenmiyor” hatası alan okurlar var. Webb bunun büyük ihtimalle bir hata olduğunu söylüyor. Önizlemede böyle pürüzler beklenir.
%1,6 ne demek?
%1,6 bir standart hata. Kabaca söylersek sonuçların çoğu gerçek değerin ±%3 civarında kalır. 1.250.000 farklı müşteri için bu, birkaç on bin kişilik bir oynama demek.
Bu sayı küçük mü, büyük mü? Bağlama göre değişir:
- Bir trend grafiğinde fark çoğu zaman görünmez. Chris Webb de kesin ve yaklaşık sorgulardan çizdiği iki çizgi grafiğin birbirinden ayırt edilemediğini gösteriyor.
- Bir kampanya hedefi “50.000 yeni müşteri” ise, ±%3’lük bir oynama hedefin tutup tutmadığı sorusunu cevapsız bırakabilir.
- Distinct count zaten toplanabilir bir ölçü değil. Mağaza bazında sayıları toplasanız genel toplamı bulamazsınız. Yaklaşık sayım bu kafa karışıklığına bir katman daha ekler: satırlar ile toplam arasındaki fark artık hem mantıktan hem tahminden gelir.
İki kamp
“BI rakamı kesin olmalı”
Bu kampa göre raporun değeri güvenden gelir. Bir rakam bir kez yanlış çıkarsa kullanıcı Excel’e döner. Aynı sayının iki raporda farklı görünmesi denetim sorusu doğurur. Finans ve satış hedefleri, prim hesapları ve resmî raporlar yaklaşık olamaz. Hız sorunu varsa çözümü model tasarımında, toplamalarda ve doğru depolama modunda aramak gerekir.
“Trend görmek yeter”
Bu kampa göre yöneticilerin çoğu kararı yönle verir, son haneyle değil. 1,4 milyar satırda altı saniye beklemek, %1,6’lık bir sapmadan daha pahalıdır: kullanıcı beklemekten sıkılıp raporu kapatır. Web analitiğinde “tekil ziyaretçi” yıllardır HyperLogLog ile sayılıyor ve kimse bundan şikâyet etmiyor. Asıl sorun hata değil, hatanın söylenmemesi.
Benim görüşüm
İki kamp da haklı, çünkü farklı ölçülerden bahsediyorlar.
Bence doğru soru “yaklaşık sayım iyi mi kötü mü?” değil, “bu ölçüyle hangi karar veriliyor?” sorusu.
- Keşif, trend ve büyük hacimli operasyonel ölçüler için yaklaşık sayım mantıklı. Örnekler: günlük tekil kart sayısı, sepet başına farklı ürün, uygulamayı açan tekil kullanıcı.
- Hedef, prim, finans ve dış raporlama için kesin sayım şart. Bir ölçü bir kişinin maaşını ya da bir sözleşmeyi etkiliyorsa yaklaşık olamaz.
- İkisini aynı ölçünün içinde saklamayın. Yaklaşık bir ölçünün adında bunu söyleyin, formatında da gösterin.
Chris Webb’in önerdiği çözüm de bu yönde: Kullanıcıya bir alan parametresiyle seçim bırakmak. Varsayılan yaklaşık sayım olur, kullanıcı hızlıca gezinip eğilimi görür, kesin rakama ihtiyaç duyduğunda tek tıkla değiştirir.
Pratikte nasıl kurulur?
Önce iki ölçüyü ayrı ayrı tanımlayın ve yaklaşık olanı biçimlendirmede belli edin:
Tekil Müşteri = DISTINCTCOUNT ( Satış[MüşteriID] )

Tekil Müşteri (≈) = APPROXIMATEDISTINCTCOUNT ( Satış[MüşteriID] )
Yaklaşık ölçünün biçim dizesini "≈ "#,0 gibi ayarlarsanız kart ve tablolarda rakamın başında “≈” işareti görünür.
Sonra Modelleme › Yeni parametre › Alanlar ile bir alan parametresi oluşturun. Power BI’ın ürettiği ifade buna benzer:
Sayım Türü = {
    ( "Hızlı (yaklaşık)", NAMEOF ( [Tekil Müşteri (≈)] ), 0 ),
    ( "Kesin", NAMEOF ( [Tekil Müşteri] ), 1 )
}
Parametreyi bir dilimleyiciye koyun, varsayılan olarak “Hızlı (yaklaşık)” seçili kalsın. Görsellerde ölçü yerine parametreyi kullanın.
Kullanmadan önce kontrol listesi
- Sütunun kardinalitesi gerçekten yüksek mi? Birkaç bin farklı değerde kazanç olmayabilir, hatta yavaşlayabilir.
- Sorgu sürelerini kendi modelinizde ölçün. Performans Analizörü ve DAX Studio ile iki ölçüyü yan yana deneyin.
- Kapasitenin bellek durumunu kontrol edin. Hız kazancı bellek baskısıyla geri gelebilir.
- Ölçü bir hedefe, prime ya da dış rapora bağlıysa kesin sayımda kalın.
- Yaklaşık ölçüyü adında ve formatında belli edin.
- Fonksiyon önizlemede. Kritik raporlarda genel kullanıma geçmesini bekleyin.
Sonuç
APPROXIMATEDISTINCTCOUNT’un Import ve Direct Lake’e gelmesi küçük bir teknik not gibi görünüyor. Aslında BI’ın eski bir varsayımını sorguluyor: her rakamın son hanesine kadar doğru olması gerektiği varsayımını. Büyük veride hız ile kesinlik arasında bir seçim var ve bu seçimi geliştiricinin tek başına yapması gerekmiyor. Kullanıcıya açıkça sunulduğunda çoğu zaman doğru tercihi kendisi yapıyor.
Siz hangi kamptasınız? Raporlarınızda “yaklaşık” bir rakamı yöneticilerinize gösterebilir misiniz? Yorumlarda konuşalım.