Yazar: @atilayberber
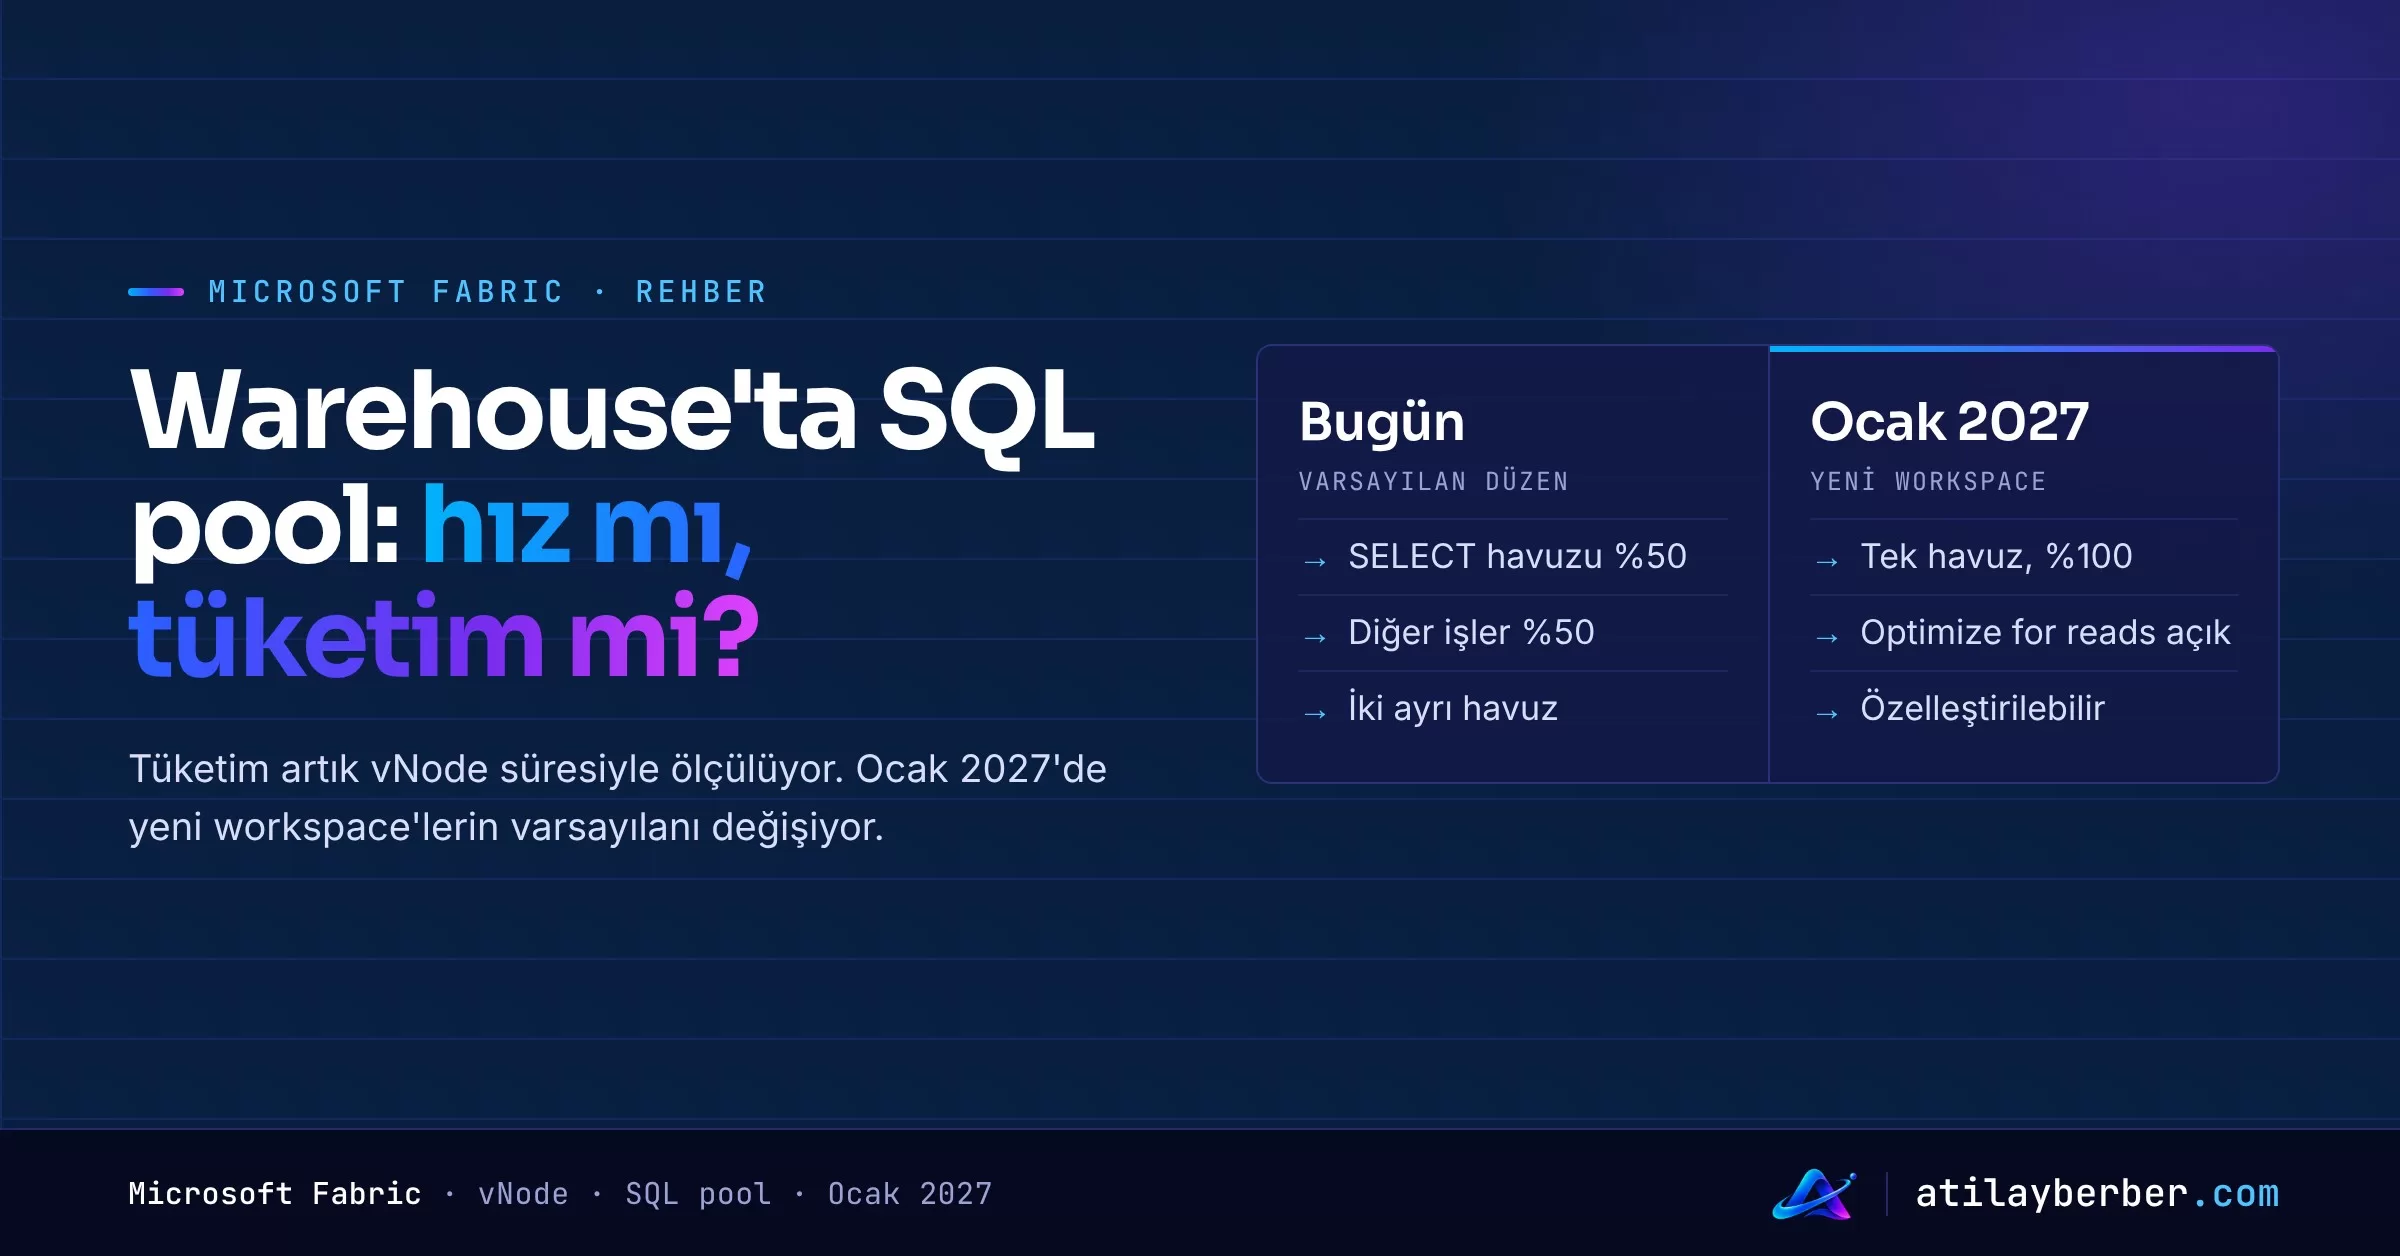
Fabric Data Warehouse’ta 2026’da iki şey sessizce değişti. Birincisi faturanın mantığı: tüketim artık sorgunun harcadığı CPU süresiyle değil, workspace’e ayrılan compute’un (vNode) açık kaldığı süreyle ölçülüyor. İkincisi bu compute’un nasıl paylaşılacağı: 9 Kasım 2026’da Microsoft, SQL pool yapılandırmasının tek modele indirileceğini ve Ocak 2027’den itibaren yeni workspace’lerin farklı bir varsayılanla açılacağını duyurdu.
İkisini yan yana koyunca ortaya şu çıkıyor: SQL pool’lar artık yalnızca “ETL raporu yavaşlatmasın” ayarı değil, warehouse tüketimini yönetmenin başlıca aracı. Bu rehberde mimariyi, Ocak 2027 takvimini, kurulumun portal ve API yolunu, hazır T-SQL izleme sorgularını ve dikkat edilmesi gereken tuzakları kaynaklarıyla anlatıyorum.
Kısaca
- Warehouse ve SQL analytics endpoint tüketimi vNode (4 vCore) üzerinden, bir dakikalık taban ayırma penceresiyle ölçülüyor. Capacity Metrics artık sorgu değil, faturalama aralığı gösteriyor.
- Varsayılan düzende compute, SELECT ve SELECT olmayan iş yükleri arasında 50/50 bölünüyor. Custom SQL pool’larla bunu en fazla 8 havuza kadar kendiniz tasarlayabiliyorsunuz.
- Ocak 2027’den itibaren yeni workspace’ler tek bir, okuma için optimize edilmiş ve compute’un %100’üne erişebilen havuzla açılacak. Mevcut workspace’lerin etkin yapılandırması değişmiyor.
- Aralık 2026 ortasına kadar API tarafında
customSQLPoolsEnabledbayrağına dayanan otomasyonların gözden geçirilmesi gerekiyor. - Havuz yüzdesi bir bütçe sınırı değil, bir iş yükünün ulaşabileceği en yüksek kaynak miktarını belirleyen bir korkuluk.
- Durum: Microsoft’un “What’s new” sayfası custom SQL pool’ları hâlâ önizleme altında listeliyor; statement type sınıflandırıcısı Eylül 2026’da GA oldu; REST API beta.
Neden şimdi önemli?
Fatura mantığı değişti: CPU süresi değil, ayrılan compute
Microsoft Learn’deki güncel tüketim dokümanı modeli şöyle tanımlıyor: Fabric, warehouse’a ve lakehouse’un SQL analytics endpoint’ine yapılan okuma/yazma etkinliği sırasında compute ayırır; ölçü birimi vNode‘dur ve bir vNode dört vCore’dan oluşur. Kaynaklar bir dakikalık taban ayırma penceresiyle ayrılır, ardından ayrılan vNode sayısı üzerinden saniye bazında raporlanır. Dokümanın özet formülü: Tüketim = Aktif vNode × Aktif süre.
Fabric operations sayfasına göre bir Data Warehouse çekirdeği 0,538 CU’ya denk. Bu iki bilgiyi birleştirince kaba bir hesap yapılabiliyor (hesap bana ait, Microsoft’un yayımladığı bir fiyat tablosu değil):
- 1 vNode = 4 × 0,538 = 2,152 CU
- Tek bir vNode’u uyandıran 10 saniyelik bir sorgu, bir dakikalık taban nedeniyle yaklaşık 60 × 2,152 = 129 CU-saniye olarak görünür.
- Aynı dakikaya sığan yirmi sorgu da, ek vNode gerektirmedikleri sürece aynı pencereyi paylaşır.
Bu değişikliğin Ağustos 2026’da devreye girdiğini ve eski modelin sorgu başına CPU süresine dayandığını Nikola Ilic (Data Mozart), Microsoft’un müşterilere gönderdiği bildirime dayanarak aktardı; “bir dakika tuzağı” tartışması da oradan çıktı. Ben o yazıyı tekrar etmeyeceğim; buradaki soru şu: bu modelde elimizdeki ayar düğmesi ne?
Pratik sonuçlardan biri de izleme tarafında. Learn’deki notla: Capacity Metrics uygulamasındaki Operation Id artık warehouse sorgularının distributed statement ID’siyle eşleşmiyor. Uygulama tamamlanmış faturalama aralıklarını gösteriyor; o aralıkta neyin çalıştığını bulmak için queryinsights.exec_requests_history görünümüne zaman aralığıyla gitmeniz gerekiyor. Ayrıca sistem katalog görünümleri ve DMV sorguları da faturalanan sorgular arasında.
Ocak 2027: yeni workspace’lerin varsayılanı değişiyor
Microsoft’un 9 Kasım 2026 tarihli duyurusuna göre yerleşik (built-in) ve özel (custom) havuz ayrımı kaldırılıyor; tüm havuzlar arayüzde ve API’de tek bir yapılandırma modeliyle temsil edilecek. Bugünkü 50/50 varsayılanın yerine yeni workspace’lerde tek havuz ve %100 erişim geliyor. Ayrıntılar aşağıda, ama önce mimariyi netleştirelim.
Mimari: Fabric Warehouse compute’u nasıl paylaştırıyor?
Varsayılan: otonom iş yükü yönetimi
Warehouse ve SQL analytics endpoint aynı dağıtık SQL motorunu kullanır. Varsayılan düzende workspace’in compute’u iki yalıtılmış havuza eşit bölünür: SELECT sorguları için bir havuz, veri yükleme ve değişiklik (DML/DDL) için bir havuz. Her biri talebe göre bağımsız ölçeklenir ama toplamın %50’sini aşamaz. Bu ayrımın amacı, gece yüklemesinin rapor sorgularını ezmesini engellemektir.
Üst sınırı kapasite SKU’su belirler. Warehouse, temel kapasitenin üzerine çıkıp “burst” edebilir; Learn’deki tabloya göre burst çarpanı F8–F2048 arasında 12x’e kadar, F2’de 32x’e, F4’te 16x’e kadardır. Otonom düzende bu, havuz başına 12x ve toplam 24x olarak yönetilir. Burst edilen tüketim smoothing ile zamana yayılır; smoothing ve throttling’in nasıl çalıştığını Fabric’te kapasite yönetimi yazısında anlatmıştım.
Kapsam workspace’tir: aynı workspace’teki bütün warehouse’lar ve SQL analytics endpoint’ler aynı havuzları paylaşır.
Custom SQL pool’lar: sınırı siz çizersiniz
Custom SQL pool’larla workspace yöneticisi dört şeyi değiştirebilir: havuz sayısını, isteklerin hangi havuza gideceğini, her havuzun en fazla ne kadar kaynak alabileceğini ve havuzun okuma için optimize edilip edilmeyeceğini.
| Özellik | Otonom (varsayılan) | Custom SQL pool’lar |
|---|---|---|
| Yapılandırma | Yok, hazır gelir | Portal veya REST API |
| Yetki | Gerekmez | Workspace Admin rolü |
| Havuz sayısı | 2 (SELECT / diğer) | En fazla 8 |
| Sınıflandırma | Statement type | Statement type, uygulama adı veya uygulama adı regex’i |
| Kaynak payı | Havuz başına %50 | Havuz başına yüzde; toplam %100 veya altı |
| Burst | Fabric yönetir (havuz başına 12x, toplam 24x) | Yüzdeye göre paylaşılır; toplam yine 24x |
İstekleri havuza yönlendiren özelliğe classifier deniyor. Üç türü var:
- Statement type: Tam iki havuz oluşur (
SELECTveNONSELECT), ilk değerleri %50’dir ve yüzdeleri değiştirebilirsiniz. Eylül 2026’da GA olan parça bu. - Application name: Bağlantı dizesindeki uygulama (program) adıyla tam eşleşme. Bir havuza birden çok ad verilebilir, ad 128 karakteri geçemez ve aynı ad iki havuzda olamaz.
- Application name regex: Uygulama adına düzenli ifade uygular. Listede yalnızca ilk değer değerlendirilir; bir istek birden fazla havuzun ifadesine uyarsa havuz rastgele seçilir, öncelik kuralı yoktur.
İki kural tasarımı doğrudan etkiliyor: bir workspace’te yalnızca tek bir classifier türü kullanılabilir ve tam olarak bir havuz varsayılan (default) olmalıdır; hiçbir kurala uymayan istekler oraya düşer.
“Optimize for reads” ve cache cooldown
Her havuzda bir Optimize for reads seçeneği var. Learn bunu tek cümleyle tanımlıyor: havuzun SELECT türü sorgular için optimize edilmesini istiyorsanız işaretleyin. Daha fazlasını birleştirme duyurusundan öğreniyoruz: önbelleği az yeniden kullanan, yükleme ağırlıklı iş yüklerinde bu seçeneği kapatmak “gereksiz önbellek kaynaklı tüketimi” önler; ayrıca etkinlik bittikten sonra compute’un ayrılmış kaldığı varsayılan beş dakikalık cache cooldown süresi, yapılandırılabilir hâle geldiğinde kısaltılabilecek.
Buradan çıkardığım sonuç (yorum bana ait): okuma için optimize edilmiş bir havuz, sıcak önbellekle daha hızlı rapor demek, ama boşta geçen dakikaların bir kısmı da tüketime yazılıyor. Seyrek ve kısa sorgularla uyanan bir workspace’te bu takas aleyhinize işleyebilir. Kesin etkisini dokümanlar rakamla vermiyor; kendi Capacity Metrics verinizle ölçmeniz gerekiyor.
Ocak 2027’de ne değişiyor?
| Senaryo | Ne olacak? |
|---|---|
| Mevcut workspace | Etkin havuz yapılandırması ve iş yükü davranışı aynı kalır. Daha önce gönderilmiş ama etkin olmayan yapılandırmalar arayüzde ve GET yanıtında artık görünmez. |
| Yeni workspace (Ocak 2027’den itibaren) | Tek havuz, Optimize for reads açık, compute’un %100‘üne erişim. İsterseniz özelleştirirsiniz. |
| API entegrasyonları | customSQLPoolsEnabled bayrağı kaldırılıyor. GET yalnızca etkin yapılandırmayı döndürecek; PATCH gövdesinde bayrak olmayacak, havuz listesi aynı kalacak. |
Takvim iki adımlı:
- Aralık 2026 ortasına kadar: Etkin olmayan yapılandırmaları okumak için
customSQLPoolsEnabledbayrağına güvenmeyi bırakın. - Ocak 2027 yayılımından önce: “Yerleşik mi, özel mi?” diye dallanan kodu kaldırın; PATCH isteklerinden bayrağın çıkacağına hazırlanın. Güncel doküman yayılımla birlikte yayımlanacak.
Maliyet tarafı duyuruda açıkça yazıyor ve yalnızca yeni workspace’leri ilgilendiriyor: SELECT sorguları da, yükleme işlemleri de bugünkü %50 yerine compute’un %100’üne kadar çıkabilecek. Bu, işlerin daha hızlı bitmesi ama daha fazla compute tüketmesi anlamına gelebilir. Microsoft’un önerdiği üç fren: havuzlara daha küçük yüzde vermek, yükleme ağırlıklı işlerde Optimize for reads’i kapatmak ve (kullanıma açıldığında) cooldown süresini kısaltmak.
Benim okumam: mevcut ortamınızda acil bir şey kırılmıyor. Ama Ocak’tan sonra açtığınız her yeni workspace, eskilerden farklı bir tüketim profiliyle doğacak. Workspace’leri şablonla ya da otomasyonla açıyorsanız havuz yapılandırmasını o şablonun parçası yapmak mantıklı.
Adım adım uygulama
1. Önce envanter: kim, hangi adla bağlanıyor?
Havuz tasarlamadan önce trafiğin kendisine bakın. queryinsights.exec_requests_history, tamamlanan her istek için program_name (uygulama adı) ve sql_pool_name (kullanılan havuz) alanlarını tutar. Query Insights verisi 30 gün saklanır ve bir sorgunun görünmesi 15 dakikayı bulabilir.
SELECT
    program_name,
    sql_pool_name,
    statement_type,
    COUNT(*)                             AS istek_sayisi,
    SUM(allocated_cpu_time_ms) / 1000.0  AS vcore_saniye,
    SUM(data_scanned_remote_storage_mb)  AS onelake_mb,
    SUM(data_scanned_memory_mb + data_scanned_disk_mb) AS onbellek_mb
FROM queryinsights.exec_requests_history
WHERE start_time >= DATEADD(DAY, -14, GETUTCDATE())
GROUP BY program_name, sql_pool_name, statement_type
ORDER BY vcore_saniye DESC;
Bu çıktı üç soruyu yanıtlar: hangi uygulama adları gerçekten var, hangisi en çok kaynak kullanıyor ve hangisi önbellekten yararlanıyor (onelake_mb yüksek, onbellek_mb düşükse önbellek pek işe yaramıyor demektir). sql_pool_name alanı, dağıtık çalıştırma gerektirmeyen hafif sorgularda boş gelir; bu normal.
Bir dakikalık pencereyi düşünerek ikinci bir bakış da işe yarar: saat başına kaç ayrı dakikada sorgu başlamış?
SELECT
    CAST(start_time AS date)        AS gun,
    DATEPART(HOUR, start_time)      AS saat,
    COUNT(DISTINCT DATEDIFF(MINUTE, '2026-01-01', start_time)) AS sorgu_baslayan_dakika,
    COUNT(*)                        AS istek_sayisi
FROM queryinsights.exec_requests_history
WHERE start_time >= DATEADD(DAY, -7, GETUTCDATE())
GROUP BY CAST(start_time AS date), DATEPART(HOUR, start_time)
ORDER BY gun, saat;
Az sayıda istekle çok sayıda dakikanın “uyandığı” saatler, seyrek ve dağınık trafiğin işaretidir. Bu sorgu yalnızca başlangıç dakikalarını sayar, faturayı hesaplamaz; nereye bakacağınızı gösterir.
2. Havuzları tasarlayın
Karar sırası şöyle olmalı:
- Classifier türü. Yalnızca okuma/yazma ayrımının oranını değiştirmek istiyorsanız statement type yeter. Uygulamaları ayırmak istiyorsanız application name gerekir. Adında GUID gibi değişken parçalar olan trafik (örneğin Fabric pipeline’ları) için regex şart.
- Varsayılan havuz. Tanımadığınız her şey buraya düşer. En geniş ve en kritik trafiği varsayılan yapmak, unutulan bir uygulamanın dar bir havuza sıkışmasını önler.
- Yüzdeler. Toplam %100’ü geçemez ama %100’e tamamlamak zorunda da değilsiniz. Toplamı bilerek düşük tutmak, Learn’ün “kapasite throttling” senaryosunda önerdiği yöntemin kendisi.
- Optimize for reads. Tekrarlayan rapor sorguları için açık, yükleme havuzları için kapalı başlamak makul.
Learn, Fabric’in kendi trafiği için hazır değerler veriyor:
- Fabric pipeline’ları:
^Data Integration-to[0-9a-fA-F]{8}-[0-9a-fA-F]{4}-[1-5][0-9a-fA-F]{3}-[89abAB][0-9a-fA-F]{3}-[0-9a-fA-F]{12}$ - Power BI:
^(PowerBIPremium-DirectQuery|Mashup Engine(?: \(PowerBIPremium-Import\))?) - Fabric portalındaki SQL sorgu düzenleyicisi:
DMS_user
3. Portalda kurulum
- Workspace’te Workspace settings‘i açın, Data Warehouse bölümünü genişletip SQL Pools sayfasına gidin. Varsayılan düzendeyken sayfada Using built-in pools yazar.
- Set up custom pools‘u seçin.
- Classifier type listesinden türü seçin: Application name (exact name), Application name (regex) ya da Statement type.
- İlk havuz otomatik oluşur ve varsayılan havuzdur; bu yüzden uygulama adı alanı devre dışıdır. Pool name ve Compute % değerlerini girin, gerekiyorsa Optimize for reads‘i işaretleyin.
- + New SQL Pool ile diğer havuzları ekleyin; her birine benzersiz ad, classifier değeri ve yüzde verin.
- Save ile kaydedin. Geri dönmek için aynı sayfadaki Revert to built-in setup yeterli.
4. API ile kurulum (tekrarlanabilir yol)
Aynı yapılandırmayı ortamlar arasında taşımak için API daha uygun. Aşağıdaki örnek, Learn’deki notebook örneğinin uyarlamasıdır ve bir Fabric notebook’unda çalışır. Uç nokta bugün beta olduğu için ?beta=true parametresi gerekiyor.
import json
import requests
from notebookutils import mssparkutils

workspace_id = mssparkutils.runtime.context.get('currentWorkspaceId')
url = (
    f'https://api.fabric.microsoft.com/v1/workspaces/{workspace_id}'
    '/warehouses/sqlPoolsConfiguration?beta=true'
)
headers = {'Authorization': f'Bearer {mssparkutils.credentials.getToken("pbi")}'}

# 1) Mevcut durumu oku ve sakla
current = requests.get(url, headers=headers)
print(json.dumps(current.json(), indent=4))

# 2) Yeni yapılandırma
body = {
    "customSQLPoolsEnabled": True,
    "customSQLPools": [
        {
            "name": "reporting",
            "isDefault": True,
            "maxResourcePercentage": 50,
            "optimizeForReads": True
        },
        {
            "name": "etl",
            "isDefault": False,
            "maxResourcePercentage": 35,
            "optimizeForReads": False,
            "classifier": {
                "type": "Application Name",
                "value": ["etl-nightly", "etl-hourly"]
            }
        },
        {
            "name": "adhoc",
            "isDefault": False,
            "maxResourcePercentage": 15,
            "optimizeForReads": False,
            "classifier": {
                "type": "Application Name",
                "value": ["DMS_user"]
            }
        }
    ]
}

response = requests.patch(url, json=body, headers=headers)
print(response.status_code, response.text)
Bilinmesi gerekenler:
customSQLPoolsEnabledtruedeğilse gövde yok sayılır ve otonom yönetim sürer. Bu bayrak birleştirmeyle kalkacak; yukarıdaki kodda tek satır olarak durması, Ocak’ta silmenizi kolaylaştırır.- PATCH, listeyi bütünüyle değiştirir. semantic-link-labs dokümanındaki ifadeyle, istekte yer almayan mevcut havuzlar silinir. Bu yüzden önce GET çıktısını saklayın.
- Geri dönüş:
{"customSQLPoolsEnabled": false, "customSQLPools": []}. - Ham REST yerine semantic-link-labs kullanmak isterseniz
sempy_labs.warehousealtındaget_sql_pools_configuration,enable_sql_pools_configurationvedisable_sql_pools_configurationfonksiyonları aynı API’yi sarmalıyor ve service principal ile çalışabiliyor.
5. Doğrulayın
Uygulama adının gerçekten geldiğini canlı oturumlardan görebilirsiniz:
SELECT session_id, program_name
FROM sys.dm_exec_sessions
WHERE program_name = 'etl-nightly';
10-15 dakika sonra isteğin hangi havuza düştüğünü Query Insights gösterir:
SELECT distributed_statement_id, submit_time, program_name,
       sql_pool_name, start_time, end_time
FROM queryinsights.exec_requests_history
WHERE program_name = 'etl-nightly'
ORDER BY submit_time DESC;
Uçtan uca örnek: üç iş yükü, tek workspace
Aşağıdaki senaryo kurgusaldır; yüzdeler başlangıç noktasıdır, öneri değildir.
Bir workspace’te üç tür trafik var: Power BI raporları (DirectQuery ve import yenilemeleri), Python ile yazılmış bir gece yükleme servisi ve portaldaki sorgu düzenleyicisinden çalışan analistler. Şikâyet tanıdık: analistin ağır bir sorgusu sabah raporlarını yavaşlatıyor, gece yüklemesi de kapasiteyi zorluyor.
Tasarım kararları:
- Yükleme servisi bizim kodumuz, yani bağlantı dizesine uygulama adını biz yazabiliriz. Sorgu düzenleyicisinin adı belgeli (
DMS_user). Bu ikisi tam adla yakalanabildiği için Application name türünü seçiyoruz. - Power BI trafiğinin adları değişken olduğu için onu ayrıca tanımlamıyoruz;
reportinghavuzunu varsayılan yapıyoruz. Böylece sınıflandırılmayan her şey rapor havuzuna düşüyor. reporting%50 ve okuma için optimize;etl%35 ve optimize değil;adhoc%15.
Yükleme servisinde uygulama adını bağlantı dizesine eklemek yeterli. ODBC sürücüsünde anahtar sözcük APP, .NET SqlClient’ta Application Name:
conn_str = (
    "Driver={ODBC Driver 18 for SQL Server};"
    "Server=<sql-baglanti-dizeniz>;"
    "Database=<warehouse-adi>;"
    "APP=etl-nightly;"
    "Encrypt=yes;"
    # kimlik doğrulama parametreleri ortamınıza göre eklenir
)
Bir hafta sonra bakılacak ilk yer baskı kayıtları. queryinsights.sql_pool_insights; havuz yapılandırması, kapasite ya da baskı durumu değiştiğinde satır yazar. Baskı durumu ancak en az bir dakika sürerse kaydedilir.
SELECT [timestamp], sql_pool_name, max_resource_percentage,
       is_optimized_for_reads, current_workspace_capacity,
       is_pool_under_pressure
FROM queryinsights.sql_pool_insights
WHERE is_pool_under_pressure = 1
  AND [timestamp] > DATEADD(WEEK, -1, GETDATE())
ORDER BY [timestamp] DESC, sql_pool_name;
Baskı anında neyin çalıştığını görmek için Microsoft’un SQL Pool Insights duyurusundaki kalıp:
WITH Pool_Pressure_Events AS (
    SELECT DISTINCT [timestamp]
    FROM queryinsights.sql_pool_insights
    WHERE is_pool_under_pressure = 1
)
SELECT erh.sql_pool_name, erh.program_name, erh.start_time,
       erh.total_elapsed_time_ms, erh.allocated_cpu_time_ms, erh.command
FROM queryinsights.exec_requests_history AS erh
JOIN Pool_Pressure_Events AS ppe
  ON ppe.[timestamp] BETWEEN erh.start_time AND erh.end_time
ORDER BY erh.allocated_cpu_time_ms DESC;
Sonuca göre karar: adhoc sürekli baskı altındaysa ve bu kabul edilebilir bir şeyse (analist sorgusu biraz bekler) dokunmayın; havuzun işi zaten bu. reporting baskı altındaysa etl ya da adhoc payından alıp ona verin. Yüzde değiştirmek çalışan sorguları düşürmez.
Pahalı aralığı bulmak: Capacity Metrics’ten warehouse’a
Kasım 2026 başında GA olan Monitor in warehouse eylemi, kapasite görünümünü doğrudan Warehouse Monitor’e bağlıyor: Capacity Metrics’te Compute sayfasından bir zaman noktası seçip Explore ile TimePoint Detail’e gidiyor, arka plan işlemleri arasından bir warehouse sorgu işlemini seçip Monitor in warehouse‘a basıyorsunuz. Warehouse, ilgili zaman aralığı uygulanmış olarak açılıyor. Gereken yetki: Capacity Metrics uygulamasına erişim ve warehouse’un bulunduğu workspace’te Admin rolü.
Microsoft’un önerisi CPU süresine göre sıralayıp Data scanned, Result cache hit, Label ve Is distributed sütunlarını birlikte okumak. Önemli bir uyarı da aynı yazıda: CPU süresi, tek bir sorgu için faturalanan CU değildir. Yani bu ekran “hangi sorgu pahalıydı?” sorusuna değil, “o aralıkta compute’u kim meşgul ediyordu?” sorusuna cevap verir. Workspace düzeyinde kalıcı izleme istiyorsanız Workspace Monitoring rehberine bakabilirsiniz.
Tuzaklar ve sorun giderme
- Havuzu silmek çalışan sorguyu iptal eder. Silinen havuzda çalışan sorgu “Query canceled by user” hatasıyla düşer. Yeniden boyutlandırma ise sorgu düşürmez. Yapıyı değiştirecekseniz yükleme penceresinin dışında yapın.
- Kapasite küçültme havuzu sıfırlayabilir. SKU değişince havuzlar yeni boyuta kendiliğinden ölçeklenir; ama küçültme bir havuzu sıfır düğüme indirirse sorgular “The assigned SQL pool for this query has no resources and must be reconfigured.” hatası verir. Küçük yüzdeli havuzlarla küçük SKU’larda buna dikkat.
- Regex çakışması sessizdir. İki havuzun ifadesi aynı isteğe uyarsa seçim rastgele olur ve hata almazsınız. İfadeleri
^ve$ile sabitleyin, doğrulama sorgusuyla kontrol edin. - Tek classifier türü. Aynı workspace’te bir havuzu statement type ile, diğerini uygulama adıyla tanımlayamazsınız. İkisine de ihtiyaç varsa iş yüklerini workspace’lere ayırmak gerekir.
sql_pool_nameboşsa panik yok. Dağıtık çalıştırma gerektirmeyen sorgular havuza atanmaz.- Kayıtlarda boşluk olabilir.
sql_pool_insightsyalnızca warehouse etkinken kayıt tutar. - Kapsam workspace. Havuzlar o workspace’teki tüm warehouse’ları ve SQL analytics endpoint’leri kapsar. Direct Lake modeliniz DirectQuery’ye düşüyorsa o sorgular da aynı compute’tan yer; düşme konusunu Direct Lake yazısında anlatmıştım.
- API beta. Sözleşme değişebilir; Ocak’taki birleştirme bunun somut örneği.
Yönetişim ve maliyet notları
Yüzde, bütçe değildir. Microsoft’un bu konudaki blog yazısı bunu açıkça söylüyor: havuzlar doğrudan harcama sınırı ya da bütçe tavanı değil, bir iş yükünün erişebileceği en yüksek kaynağı belirleyen korkuluklar. Gecikmeye duyarlı olmayan bir yüklemeyi dar bir havuza almak, işin daha uzun sürmesi ama kaynağı daha düzgün bir hızla tüketmesi demek. Faturayı garanti etmez, tepe noktalarını törpüler.
Workspace parçalanması artık bir maliyet konusu. Bir dakikalık taban workspace başına işlediği için, aynı küçük sorguların on ayrı workspace’e dağılması ile tek workspace’te toplanması aynı şey değil; bu noktayı Nikola Ilic örneklerle gösteriyor. Öte yandan Learn, workspace’i bir izolasyon sınırı olarak kullanmayı da öneriyor. Yani güvenlik ve sahiplik için böldüğünüz workspace’lerin bir tüketim bedeli olabilir; bunu bilerek karar verin.
Çok workspace’li ortamlarda envanter. Havuz ayarı workspace başına yapıldığı için yüzlerce workspace’te “hangisi hâlâ varsayılanda?” sorusu elle yanıtlanamaz. Microsoft’tan Mark Pryce-Maher’in GitHub’daki notebook’u bütün workspace’leri dolaşıp yapılandırmayı Delta tablolarına yazıyor; varsayılan olarak yalnızca okuyor (DRY_RUN). Resmî bir ürün değil, MIT lisanslı bir örnek; önce test workspace’inde deneyin.
Kim değiştirebilir? Yalnızca workspace Admin rolü. Bu, üretim workspace’lerinde Admin sayısını gözden geçirmek için ek bir neden.
Kapasite modelinin genel takaslarını Fabric ve Databricks maliyet karşılaştırmasında tartışmıştım; SQL pool’lar o tartışmada Fabric tarafına eklenen yeni bir kontrol.
Kontrol listesi
Ocak 2027’den önce:
- SQL pool API’sini çağıran betik, pipeline ya da araç var mı?
customSQLPoolsEnabledgeçen her yeri bulun. - Etkin olmayan eski yapılandırmalara ihtiyacınız varsa Aralık ortasından önce GET ile alıp saklayın.
- Yeni workspace açma sürecinize (şablon, betik, CI/CD) havuz yapılandırması adımını ekleyin.
- Yükleme ağırlıklı workspace’lerde Optimize for reads kararını bilinçli verin.
Her workspace için:
- Envanter sorgusunu çalıştırın: uygulama adları, kaynak kullanımı, önbellek oranı.
- Classifier türünü ve varsayılan havuzu seçin.
- Yüzdeleri atayın; toplamı gerekçesiyle belgeleyin.
- GET çıktısını sakladıktan sonra uygulayın.
- 15 dakika sonra
sql_pool_nameile doğrulayın. - Bir hafta sonra
sql_pool_insightsve Capacity Metrics ile gözden geçirin.
Sonuç
SQL pool’lar tek başına okunduğunda bir performans ayarı gibi duruyor. vNode tabanlı tüketim modeli ve Ocak 2027 varsayılanıyla birlikte okunduğunda ise warehouse’ta “ne kadar hızlı” ile “ne kadar tüketim” arasındaki dengeyi kurduğunuz yer oluyor. Mevcut workspace’leriniz yerinde duruyor; değişen, bundan sonra açacaklarınız ve otomasyonunuz.
Siz hangi düzendesiniz: varsayılan 50/50 mi, kendi havuzlarınız mı? Optimize for reads’i kapattığınızda tüketimde fark gördünüz mü? LinkedIn’de yazın, ölçümlerinizi merak ediyorum.
Kaynaklar
- Unifying SQL Pools: Upcoming changes to UI and APIs – Microsoft Fabric Updates Blog (9 Kasım 2026)
- Custom SQL pools – Microsoft Learn
- Configure custom SQL pools in the Fabric portal – Microsoft Learn
- Configure custom SQL pools by using the Fabric REST API – Microsoft Learn
- Workload management – Microsoft Learn
- Warehouse consumption and utilization – Microsoft Learn
- Burstable capacity in Fabric Data Warehouse – Microsoft Learn
- Fabric operations (CU oranları) – Microsoft Learn
- queryinsights.exec_requests_history – Microsoft Learn
- queryinsights.sql_pool_insights – Microsoft Learn
- Query insights – Microsoft Learn
- What’s new in Microsoft Fabric – Microsoft Learn
- Find expensive queries from Capacity Metrics (GA) – Microsoft Fabric Updates Blog
- Using Custom SQL Pools to balance performance and cost in Fabric Data Warehouse – Microsoft Fabric Updates Blog
- Introducing SQL Pool Insights in Microsoft Fabric Data Warehouse – Microsoft Fabric Updates Blog
- One-minute trap! How new Fabric Warehouse CU metering affect your workloads – Nikola Ilic, Data Mozart
- sempy_labs.warehouse – semantic-link-labs dokümantasyonu
- fabric-sql-pools-config – Mark Pryce-Maher, GitHub