Yazar: @atilayberber
DAX’ta metin aramak yıllardır aynı iki fonksiyona dayanıyordu: SEARCH ve CONTAINSSTRING. İkisi de bir karakter dizisini arar, kelimenin anlamını bilmez, yazım hatasını affetmez ve büyük tablolarda yavaşlar. “Geç teslimat” diye arayıp “teslimat gecikti” yazan müşteriyi bulamazsınız.
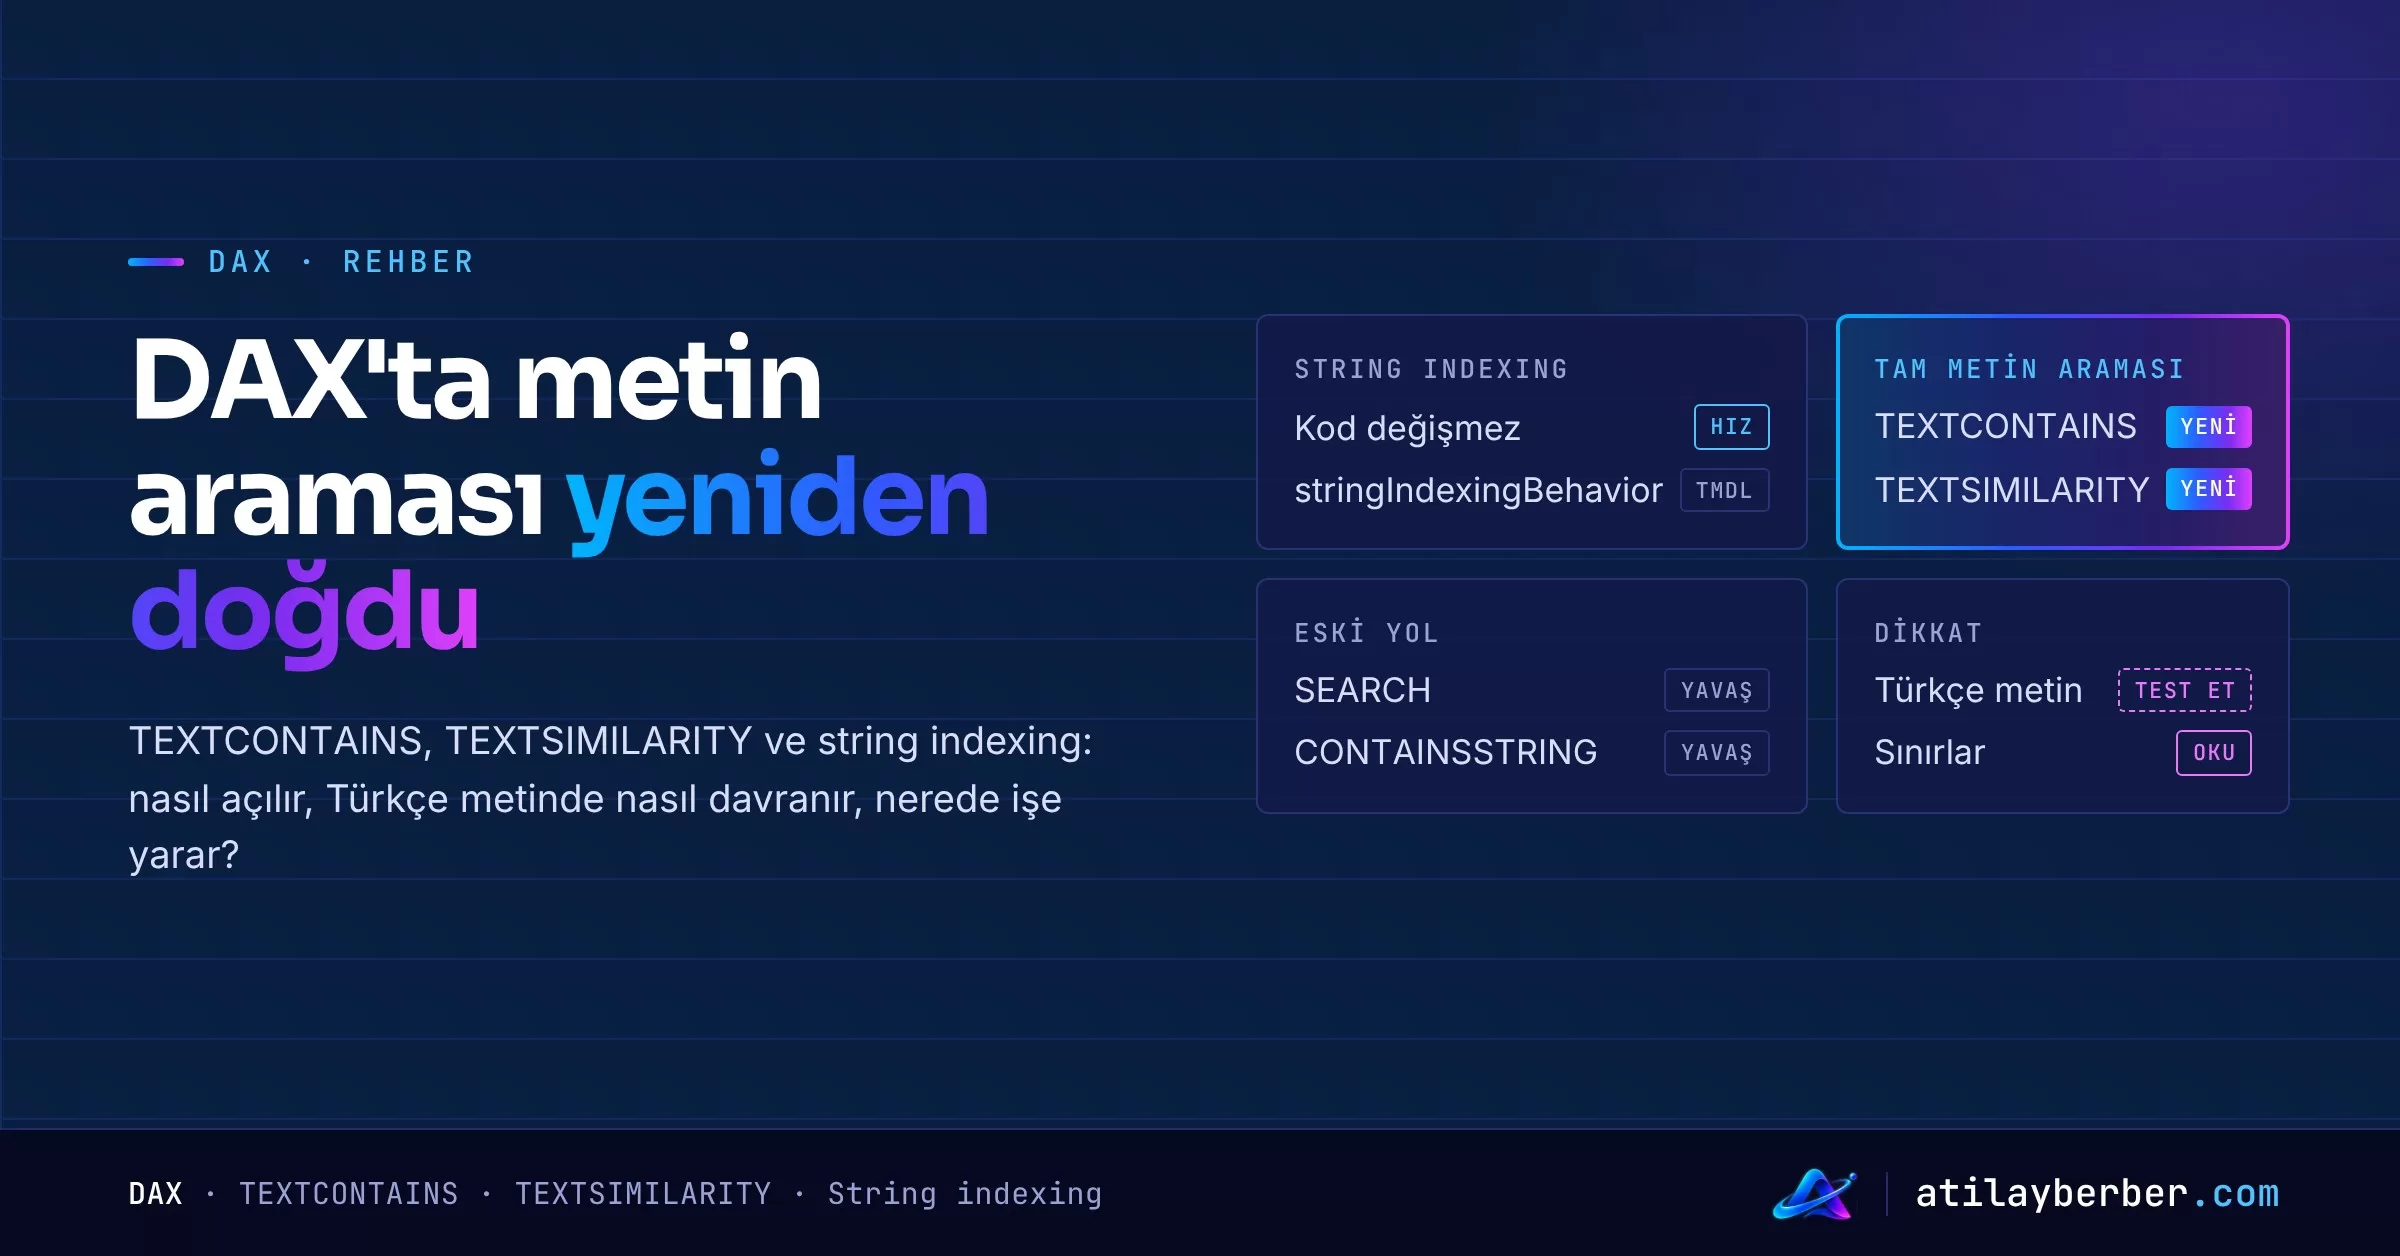
Power BI’ın Eylül 2026 güncellemesi bu tabloyu değiştiriyor. İki yeni özellik önizlemeye çıktı: mevcut metin fonksiyonlarını hızlandıran string indexing ve DAX’a gerçek bir arama motoru getiren tam metin araması (full-text search). İkincisiyle birlikte iki yeni fonksiyon geliyor: TEXTCONTAINS ve TEXTSIMILARITY.
Bu yazıda ikisini de açıyor, Türkçe metinlerde nasıl davrandıklarına bakıyor ve perakendeden örneklerle nerede işe yaradıklarını gösteriyorum.
Kısaca
- String indexing (uyumluluk düzeyi 1707):
SEARCH,CONTAINSSTRINGve gelişmiş metin dilimleyicilerini hızlandırır. Kodunuzu değiştirmeniz gerekmez. - Tam metin araması (uyumluluk düzeyi 1708): Sütun düzeyinde bir arama indeksi kurar. Kök bulma (stemming), etkisiz kelimeleri atma, öbek eşleşmesi ve yazım hatası toleransı sağlar.
- TEXTCONTAINS doğru/yanlış döndürür, TEXTSIMILARITY bir alaka puanı verir.
- Türkçe, desteklenen dillerden biri. Analizör dilini modelin dili belirler.
- İkisi de önizlemede ve şimdilik TMDL ya da XMLA ile açılıyor. Desktop arayüzü sonra gelecek.
İki özellik, iki ayrı iş
İsimleri benziyor ama farklı sorunları çözüyorlar:
| String indexing | Tam metin araması | |
|---|---|---|
| Ne yapar? | Mevcut karakter aramasını hızlandırır | Kelime anlamıyla arama yapar |
| Hangi fonksiyonlar? | SEARCH, CONTAINSSTRING, metin dilimleyicileri | TEXTCONTAINS, TEXTSIMILARITY |
| Uyumluluk düzeyi | 1707+ | 1708+ |
| Depolama modu | Import, Direct Lake | Import, Dual, Direct Lake |
| Kodu değiştirmek gerekir mi? | Hayır | Evet, yeni fonksiyonlar |
Kısacası string indexing “aynı aramayı daha hızlı” yapar. Tam metin araması ise “daha akıllı” bir arama sunar.
String indexing: kod değiştirmeden hızlanmak
String indexing’in iki modu var:
- Auto: Uygun bir sütuna ilk sorgu geldiğinde indeksi bellekte kurar. İndeks kalıcı değildir; sütun bellekten atılırsa yeniden kurulur. Microsoft küçük modeller için uygun buluyor.
- Full: İndeksi zamanlanmış yenileme sırasında kurar ve saklar. Yenileme süresi ve model boyutu biraz artar ama sorgular ilk andan itibaren hızlıdır.
Açmak için sütunun stringIndexingBehavior özelliğini full yapıyorsunuz. Bunu şimdilik web’deki TMDL görünümünden ya da XMLA uç noktası üzerinden yapabiliyorsunuz.
column 'Ürün Açıklaması'
    dataType: string
    stringIndexingBehavior: full
Özellik adının yazımını Microsoft’un duyurusundaki örnekten aldım. TMDL görünümü yanlış bir özelliği hemen işaretlediği için kaydetmeden önce kontrol etmek kolay.
Tam metin araması: DAX’a arama motoru
Tam metin araması için de aynı mantık geçerli. Arama yapılacak sütunda fullTextIndexingBehavior özelliğini full yapıyorsunuz, model de en az 1708 uyumluluk düzeyinde olmalı. Önizleme süresince Microsoft Full modu öneriyor.
column 'Yorum Metni'
    dataType: string
    fullTextIndexingBehavior: full
İndeks kurulduktan sonra iki fonksiyonu kullanabilirsiniz.
TEXTCONTAINS: eşleşiyor mu?
TEXTCONTAINS ( <metin_sütunu>, <arama_metni> [, <eşleşme_modu>] )Üç eşleşme modu var:
- TEXTMATCHING (varsayılan): Arama metnini kelimelere böler, herhangi birini içeren satırları bulur.
- FUZZYMATCHING: Küçük yazım farklarını affeder. “headfone” yazana “headphone”u bulur.
- PHRASEMATCHING: Kelimelerin yan yana ve aynı sırada geçmesini ister. Noktalama işaretleri sırayı bozmaz.
Önemli bir ayrıntı: Fonksiyon bir indeks bekler. Sütunda tam metin indeksi yoksa hata döner.
TEXTSIMILARITY: ne kadar alakalı?
TEXTSIMILARITY ( <metin_sütunu>, <arama_metni> [, <eşleşme_modu>] )Ondalıklı bir alaka puanı döndürür. Puan ne kadar yüksekse metin o kadar alakalıdır, eşleşme yoksa sıfırdır. Belgelerde sabit bir üst sınır yok. Puanlar sadece aynı arama metni ve aynı sütun içinde karşılaştırılabilir. Yani “2,35” tek başına bir anlam taşımaz; sıralamak için kullanılır.
Türkçe metinde nasıl davranıyor?
Bu bölüm Türkçe çalışanlar için en önemli kısım:
- Türkçe destekleniyor. Kök bulma ve etkisiz kelime atma, modelin diline göre çalışıyor. Desteklenen diller arasında Türkçe, İngilizce, Almanca, Fransızca, İspanyolca, Arapça ve Rusça da var.
- Dili sütun değil model belirliyor. Ayar Power BI Desktop’ta: Dosya › Seçenekler ve ayarlar › Seçenekler › Geçerli dosya › Bölgesel ayarlar › Model dili. Sütunun harmanlaması (collation) analizörü değiştirmiyor.
- Büyük/küçük harf duyarsız.
- Aksan katlama yok. Belgelerdeki örnek “café” ile “cafe”nin eşleşmediği. Türkçede bunun karşılığı “süt” ile “sut”, “şeker” ile “seker” gibi yazımlar. Müşteri yorumlarında Türkçe karakter kullanılmadan yazılmış metin çoksa FUZZYMATCHING’in bunların bir kısmını yakalayıp yakalamadığını kendi verinizle test edin.
- Desteklenmeyen bir dil seçerseniz basit bir küçük harf ayırıcı kullanılır, kök bulma ve etkisiz kelime atma devre dışı kalır.
Perakendeden üç örnek
Aşağıdaki örnekler 'Yorum' adında, her satırda bir müşteri yorumunun bulunduğu bir tabloyu varsayıyor.
1. Konu bazında şikâyet sayısı
Önce bir konu tablosu oluşturun. Bu tablo modele bağlı olmayacak, her satırda bir arama ifadesi olacak:
Konu =
DATATABLE (
    "Konu", STRING,
    "Arama", STRING,
    {
        { "Teslimat", "geç teslimat" },
        { "Tazelik", "bozuk bayat" },
        { "Fiyat", "pahalı fiyat" },
        { "Personel", "kasiyer personel" }
    }
)
Sonra seçili konunun arama ifadesiyle eşleşen yorumları sayan bir ölçü yazın:
Yorum Sayısı (Konu) =
VAR Arama = SELECTEDVALUE ( Konu[Arama] )
RETURN
    IF (
        NOT ISBLANK ( Arama ),
        COUNTROWS ( FILTER ( 'Yorum', TEXTCONTAINS ( 'Yorum'[Metin], Arama ) ) )
    )
Matriste Konu[Konu] satırlara, bu ölçü değerlere gider. Arama ifadesini bir değişkenden vermek önizlemede beklendiği gibi çalışmalı; yine de kendi modelinizde bir kez doğrulayın.
2. “Geç teslimat” öbeğini aynen arayan ölçü
Geç Teslimat Şikâyeti =
COUNTROWS (
    FILTER ( 'Yorum', TEXTCONTAINS ( 'Yorum'[Metin], "geç teslimat", PHRASEMATCHING ) )
)
TEXTMATCHING ile “geç” veya “teslimat” geçen her yorum sayılırdı. PHRASEMATCHING ise iki kelimenin yan yana geçmesini ister.
3. En alakalı beş yorumu bulmak
EVALUATE
TOPN (
    5,
    FILTER ( 'Yorum', TEXTCONTAINS ( 'Yorum'[Metin], "soğuk zincir" ) ),
    TEXTSIMILARITY ( 'Yorum'[Metin], "soğuk zincir bozuldu" ), DESC
)
Önce TEXTCONTAINS ile aday satırlar daraltılıyor, sonra TEXTSIMILARITY ile sıralanıyor. Belgelere göre iki fonksiyon birbirinden bağımsız çalışır; filtrelemek, puanlamanın kullandığı indeksi değiştirmez.
Bilmeniz gereken sınırlar
- Önizleme. Davranış ve söz dizimi değişebilir. Kritik bir rapora koymadan önce bekleyin ya da test edin.
- Arayüz yok. Açmak için şimdilik TMDL görünümü (web) veya XMLA gerekiyor. Desktop desteği daha sonra gelecek.
- Satır satır çalışır. Microsoft, çok büyük bir tabloda hesaplanmış sütun olarak kullanmadan önce gerçekçi bir iş yüküyle performans testi yapılmasını öneriyor.
- Yenileme maliyeti. İndeks yenileme sırasında kuruluyor. Chris Webb’in testinde 160 bin satırlık ve 73 bin farklı değerli kısa bir sütun için indeks yaklaşık 1,4 saniyede kuruldu. Uzun metinlerde ve çok sayıda sütunda bu süre belirgin şekilde artar. Profiler’da “Finished building persisted full-text index” mesajlı Progress Report olaylarıyla izleyebilirsiniz.
- Her sütunu indekslemeyin. Microsoft da çok sayıda metin sütununa indeks eklemenin yenilemeyi ciddi biçimde yavaşlatabileceği konusunda uyarıyor.
- Dilimleyiciler henüz yararlanmıyor. Chris Webb’e göre dilimleyicideki arama şimdilik tam metin indeksini kullanmıyor; fonksiyonlar ölçülerde ve hesaplanmış sütunlarda çalışıyor.
Nereden başlamalı?
- Modelde gerçekten aranan bir metin sütunu seçin: ürün açıklaması, müşteri yorumu, çağrı merkezi notu.
- Modelin dilini kontrol edin; Türkçe metin için Türkçe olmalı.
- Önce string indexing’i deneyin. Mevcut
SEARCHveCONTAINSSTRINGölçüleriniz kod değişmeden hızlanıyor mu, ölçün. - Anlam bazlı aramaya ihtiyaç varsa tam metin indeksini tek bir sütunda açın, yenileme süresini karşılaştırın.
- TEXTCONTAINS ile basit bir sayım ölçüsü yazın, sonra TEXTSIMILARITY ile sıralama ekleyin.
Bu iki fonksiyon, “verimle konuşmak” senaryoları için de önemli bir parça. Bir veri ajanı ya da Copilot, serbest metin içeren sütunlarda artık karakter eşleşmesinden daha iyisini yapabilecek. Copilot’un modelinizi nasıl okuduğunu anlattığım yazıda bahsettiğim “ikna edici yanlış” cevapların bir kısmı da tam olarak bu tür aramalardan çıkıyordu.
Siz modelinizde hangi metin sütununu ilk deneyeceksiniz? Yorumlarda yazın.