Yazar: @atilayberber
Son bir yılda Power BI dünyasında en sık duyduğum cümle şuydu: “Copilot gelince modelle bu kadar uğraşmamıza gerek kalmayacak.” Mantık basit görünüyor: Yapay zekâ yeterince akıllıysa, tbl_FCT_SLS_2 adlı tabloyu, Ölçü 7 adlı ölçüyü ve gizlenmemiş on iki ID sütununu kendisi çözer.
Çözmüyor. Ve bence 2026’nın BI dünyasındaki en büyük yanılgısı bu.
Bu yazı biraz ters köşe bir yazı. Herkes Copilot’un, data agent’ların ve Power BI ajanlarının neler yapabildiğini konuşurken, ben neden yapamadıklarını ve bunun sebebinin neredeyse her zaman yapay zekâ değil model olduğunu anlatmak istiyorum.
Kısaca: Bu yazıda neler var?
- Copilot raporunuzu değil, modelinizi okuyor
- Kötü modelin AI çağındaki yeni maliyeti: “ikna edici yanlış”
- Copilot’u yanıltan yedi model hatası
- Prep data for AI: AI data schema, AI instructions ve verified answers
- İki kamp: “AI veriyi kendisi anlar” ve “Önce temel”
- Copilot’a açmadan önce bir modelin geçmesi gereken kontrol listesi
Copilot raporunuzu değil, modelinizi okuyor
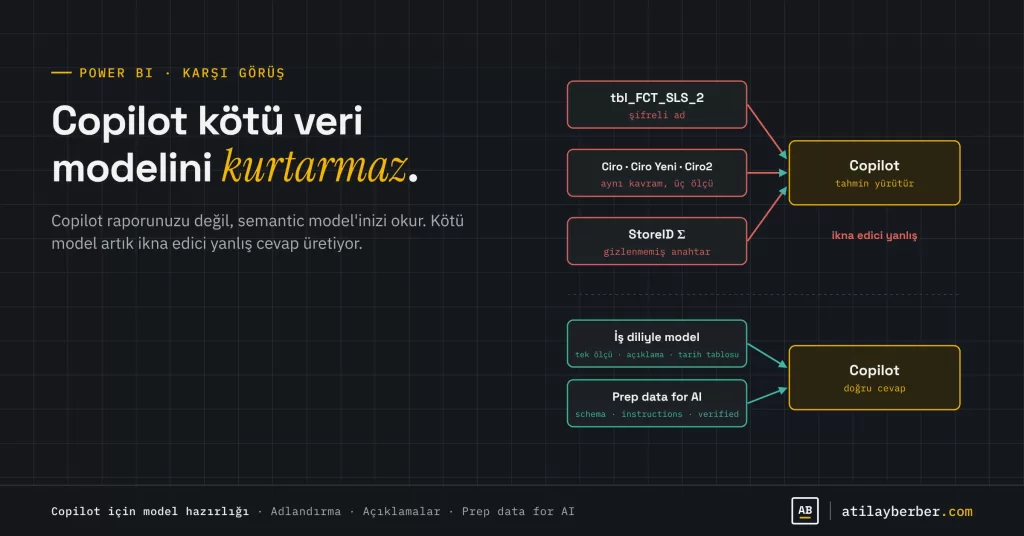
Bu, tartışmanın tamamını özetleyen cümle. Copilot ve Fabric data agent’ları, ekranda gördüğünüz güzel görsellerden değil, semantic model’in içinden besleniyor: tablo ve sütun adları, açıklamalar, eş anlamlılar, ilişkiler ve sizin tanımladığınız (ya da tanımlamadığınız) ölçüler.
Fabric Community’de Haziran 2026’da yayımlanan bir yazı da aynı noktayı vurguluyordu: Copilot ve data agent’ların cevap kalitesi, Power BI semantic model’inin içindeki bağlama bağlı. AI’ın cevapları, altındaki semantic model kadar iyi.
Bunun pratik sonucu şu: Yıllarca “son kullanıcı zaten modeli görmüyor, raporu görüyor” diyerek ertelenen model hijyeni, artık doğrudan son kullanıcının aldığı cevabı belirliyor. Çünkü Copilot ile son kullanıcı modelle doğrudan konuşuyor.
Kötü modelin yeni maliyeti: “İkna edici yanlış”
Eskiden kötü bir model kötü bir rapor üretirdi. Kötü raporun bir avantajı vardı: Genellikle kötü göründüğü belli olurdu. Garip bir toplam, boş bir görsel, anlamsız bir filtre; kullanıcı şüphelenir, BI ekibini arardı.
Copilot’un ürettiği yanlış cevap ise öyle değil. Akıcı bir dille yazılmış, tutarlı görünen, kaynak göstermeye çalışan bir paragraf. Kullanıcının şüphelenmesi için hiçbir görsel ipucu yok. Microsoft’un kendi dokümantasyonu da Copilot çıktısının deterministik olmadığını, aynı soruya her seferinde aynı cevabı garanti etmediğini açıkça belirtiyor.
Yani kötü modelin maliyeti AI çağında azalmadı, arttı. Artık sadece yanlış rakam değil, güvenle sunulan yanlış rakam üretiyor.
Copilot’u yanıltan yedi model hatası
Örnekleri perakendeden veriyorum, ama hatalar her sektörde aynı:
- Şifreli adlar.
MGZ_KD,Tutar2,NetSls_v3. İnsan bir kez öğrenir ve unutmaz; Copilot her seferinde tahmin eder. “Mağaza Kodu”, “İndirimli Tutar”, “Net Satış” gibi iş diline uygun adlar en ucuz iyileştirme. - Gizlenmemiş anahtar sütunlar.
UrunID,MagazaID,TarihKeygörünür durdukça Copilot onları toplanacak sayılar sanabiliyor. “Toplam ürün ID’si” gibi anlamsız sonuçların kaynağı genellikle bu. - Aynı kavram için birden fazla ölçü.
Ciro,Ciro (KDV Hariç),Ciro Yeni,Ciro - Kullanma. Kullanıcı “ciro” dediğinde hangisi? Copilot da bilmiyor. - Açıklaması olmayan ölçüler. Ölçünün KDV dahil mi, iadeler düşülmüş mü, hangi mağazaları kapsadığı yazmıyorsa, Copilot bunu adından tahmin etmeye çalışır. Açıklamaları Copilot ile nasıl hızlıca üretebileceğinizi ayrı bir yazıda anlatmıştım; ama üretilen açıklamanın doğru olduğunu kontrol etmek yine insanın işi.
- Örtük ölçülere güvenmek. Sütunu sürükleyip bırakmakla oluşan toplamlar, iş kuralını taşımaz. Kritik her metrik açık bir ölçü olarak tanımlanmalı.
- Bir tarih tablosunun olmaması ya da işaretlenmemesi. “Geçen yılın aynı dönemi” sorusu, düzgün bir tarih tablosu olmadan tutarlı cevaplanamaz. Tarih tablosu yazısında neden şart olduğunu detaylı anlatmıştım.
- Belirsiz ilişkiler. Çift yönlü filtreler, birden fazla aktif olmayan ilişki, köprü tablolar. İnsan geliştirici bile zorlanırken, Copilot’un doğru yolu seçmesini beklemek gerçekçi değil.
Fark ettiyseniz bu listede yapay zekâya özgü tek bir madde yok. Hepsi on yıldır bilinen iyi modelleme kuralları. Copilot sadece bu kuralları ihlal etmenin bedelini görünür kıldı.
Prep data for AI: Microsoft’un çözümü
Microsoft bu sorunun farkında ve Power BI’da Prep data for AI adıyla üç araç sunuyor:
| Araç | Ne işe yarar? |
|---|---|
| AI data schema | Copilot’un modelin hangi kısmını görmesini istediğinizi belirlersiniz; gereksiz ve kafa karıştırıcı alanları kapsam dışında bırakırsınız |
| AI instructions | Copilot’a iş bağlamını yazıyla anlatırsınız (“Ciro dendiğinde KDV hariç net satışı kullan” gibi) |
| Verified answers | Belirli sorulara karşılık gelen doğrulanmış görselleri tetikleyici ifadelerle tanımlarsınız |
Microsoft Learn’e göre bilmeniz gereken detaylar:
- Bütün değişiklikler rapora değil, semantic model’e kaydediliyor. Yani bir kez yapılan hazırlık, o modeli kullanan her deneyime yansıyor.
- Desktop’ta Home şeridinden, serviste semantic model üzerinden yapılabiliyor; değişikliklerin Copilot sonuçlarına yansıması birkaç dakika sürebiliyor.
- Test için Copilot panelindeki beceri seçicisi (skill picker), farklı senaryoları simüle etmeye yarıyor. Sorun giderme için tanılama dosyası indirme ve cevaplardaki “How Copilot arrived at this” bölümü kullanılıyor.
- Test edilmiş bir modeli Approved for Copilot olarak işaretleyebiliyorsunuz. Değişiklik genellikle bir saat içinde, çok raporu olan modellerde 24 saate kadar sürede etkili oluyor. Yöneticiler bağımsız Copilot deneyimini yalnızca onaylı öğelerle sınırlayabiliyor.
- Dokümantasyon şu an Prep data for AI için Q&A’nın model üzerinde açık olmasını gerektirdiğini belirtiyor. Q&A Aralık 2026 sonunda emekliye ayrılacağı için bu gereksinimin değişmesini bekliyorum; takip etmekte fayda var.
Ama şunu net söylemek gerekiyor: Prep data for AI, kötü modeli iyi yapmıyor; iyi modeli Copilot için daha anlaşılır yapıyor. On iki “Ciro” ölçüsü olan bir modele AI instruction yazarak düzen getiremezsiniz; önce modeli düzeltmeniz gerekiyor.
İki kamp
Kamp 1: “AI veriyi kendisi anlar”
- Büyük dil modelleri her yıl daha iyi. Bugün şifreli adlarla zorlanan Copilot, yarın onları bağlamdan çözebilir.
- Ajanlar model incelemesi yapabiliyor; kötü adları, gizlenmemiş anahtarları kendisi bulup düzeltebilir. Power BI ajanları yazısında bunu konuştuk.
- Her modeli mükemmel hale getirmeyi beklemek, AI’ın faydasını yıllarca ertelemek demek.
Kamp 2: “Önce temel”
- Model ne kadar akıllı olursa olsun, yazılmamış iş kuralını bilemez. “Ciro KDV hariç mi?” sorusunun cevabı verinin içinde değil, kurumun kararında.
- Ajanların modeli düzeltebilmesi doğru; ama hangi düzeltmenin doğru olduğuna yine insan karar veriyor.
- Yanlış cevabın maliyeti yüksek. Yönetici tek bir yanlış rakam gördüğünde güven kaybolur ve bir daha Copilot’a sormaz.
Benim görüşüm
Ben ikinci kamptayım, ama bir farkla: Bence bu bir “önce temel, sonra AI” sıralaması değil. Copilot, modelinizin kalite testidir. Bir modeli Copilot’a açıp kullanıcıların sorularına verilen cevapları izlemek, o modelin nerede belirsiz olduğunu gösteren en hızlı yol. Cevabın yanlış çıktığı her soru, modelde düzeltilmesi gereken bir yeri işaret ediyor.
Yani doğru strateji Copilot’u beklemek değil; Copilot’u kontrollü bir grupla açıp, ortaya çıkan her yanlış cevabı modele geri besleyen bir döngü kurmak. AI, kötü modeli kurtarmaz; ama kötü modeli görünür hale getirir. Bu da en az kurtarmak kadar değerli.
Copilot’a açmadan önce kontrol listesi
- ☐ Tüm tablo ve sütun adları iş dilinde mi?
- ☐ Anahtar ve teknik sütunlar gizli mi?
- ☐ Her kritik metrik için tek bir açık ölçü var mı?
- ☐ Her ölçünün kapsamı ve kuralları açıklamada yazıyor mu, ve biri bu açıklamaları doğruladı mı?
- ☐ İşaretlenmiş bir tarih tablosu var mı?
- ☐ İlişkiler tek yönlü ve belirsizlikten arınmış mı?
- ☐ AI data schema ile kapsam daraltıldı mı?
- ☐ En kritik terimler için AI instructions yazıldı mı?
- ☐ En sık sorulan 10 soru için verified answer tanımlandı mı?
- ☐ Model, test sonrası Approved for Copilot olarak işaretlendi mi?
Sonuç
Copilot kötü veri modelini kurtarmaz. Kötü veri modelini daha hızlı, daha akıcı ve daha ikna edici bir şekilde yanlış cevaplara dönüştürür. İyi haber şu ki bunu düzeltmek için yeni bir teknoloji gerekmiyor; on yıldır bildiğimiz iyi modelleme kuralları yeterli. Yapay zekâ çağında BI ekibinin en değerli yatırımı yeni bir AI özelliği değil, temiz, belgelenmiş ve tek bir doğruya sahip bir semantic model.
Siz ne düşünüyorsunuz: Copilot’u kurumunuzda açtınız mı, en sık hangi soruda yanlış cevap verdi? Yorumlarda ya da LinkedIn’de paylaşın.
Kaynaklar
- Prep data for AI in Power BI (Microsoft Learn)
- Copilot-Ready Power BI: Preparing Semantic Models for AI (O’Reilly)
- AI answers are only as good as the Power BI semantic model underneath (Collab365)
- Copilot in Power BI won’t fix bad data (Adastra)
- MC1218421 – Retirement of Power BI Q&A
HABERDAR OL
Yeni rehberler, kategorilere ayrılmış tek bir e-postada.
Her pazartesi, o hafta yayımlanan yazılar konu başlıklarına göre derlenmiş olarak gelen kutunda. Yeni yazı yoksa e-posta da yok.
1 yorum